H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

【赞助商】
通勤路上就听AI每周谈。AI每周谈,每周带你回顾上周AI大事
传送门 🔗https://www.xiaoyuzhoufm.com/podcast/688a34636f5a275f1cba40fd
【目录】
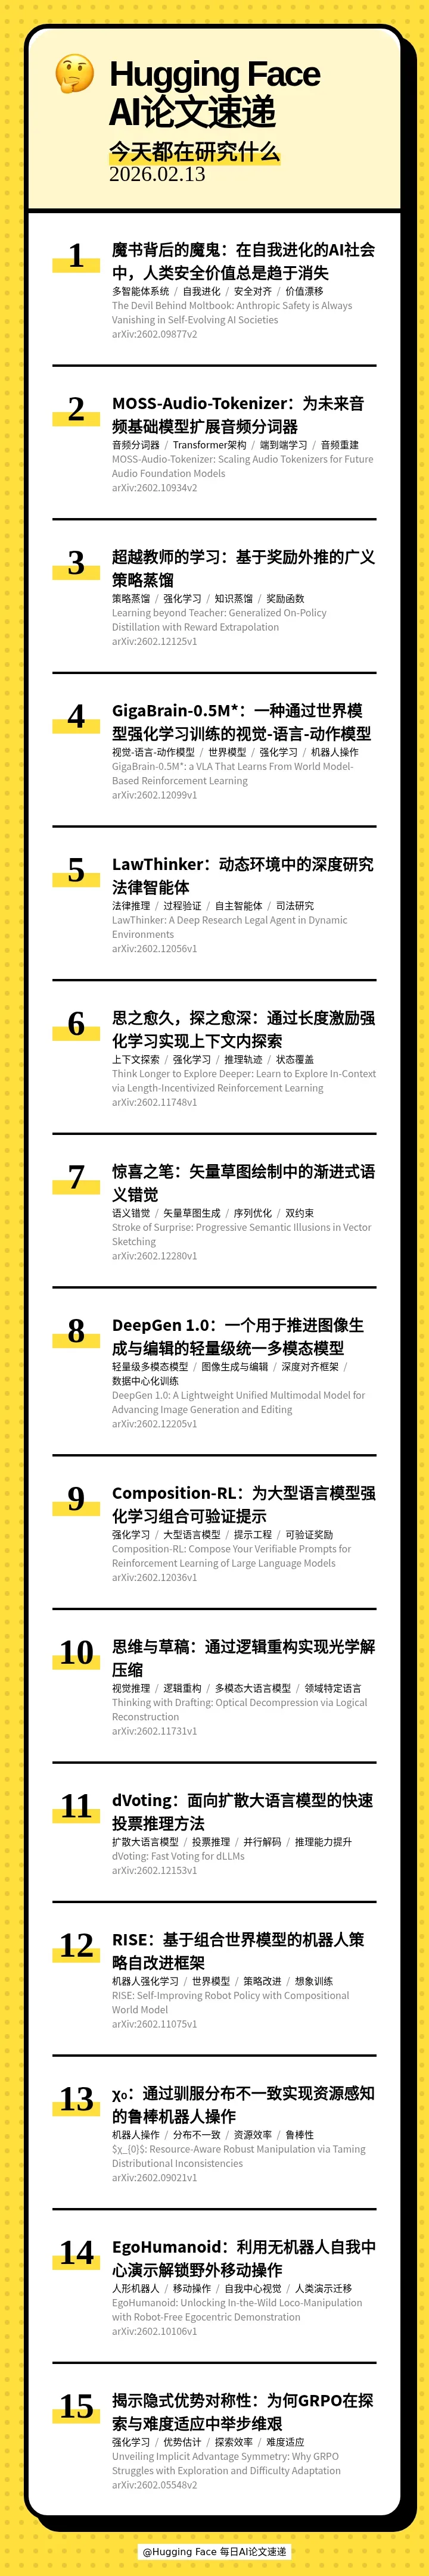
本期的 15 篇论文如下:
[] ⚠ The Devil Behind Moltbook: Anthropic Safety is Always Vanishing in Self-Evolving AI Societies(魔书背后的魔鬼:在自我进化的AI社会中,人类安全价值总是趋于消失)
[] 🎵 MOSS-Audio-Tokenizer: Scaling Audio Tokenizers for Future Audio Foundation Models(MOSS-Audio-Tokenizer:为未来音频基础模型扩展音频分词器)
[] 🧠 Learning beyond Teacher: Generalized On-Policy Distillation with Reward Extrapolation(超越教师的学习:基于奖励外推的广义策略蒸馏)
[] 🤖 GigaBrain-0.5M*: a VLA That Learns From World Model-Based Reinforcement Learning(GigaBrain-0.5M*:一种通过世界模型强化学习训练的视觉-语言-动作模型)
[] ⚖ LawThinker: A Deep Research Legal Agent in Dynamic Environments(LawThinker:动态环境中的深度研究法律智能体)
[] 🔍 Think Longer to Explore Deeper: Learn to Explore In-Context via Length-Incentivized Reinforcement Learning(思之愈久,探之愈深:通过长度激励强化学习实现上下文内探索)
[] 🎨 Stroke of Surprise: Progressive Semantic Illusions in Vector Sketching(惊喜之笔:矢量草图绘制中的渐进式语义错觉)
[] 🚀 DeepGen 1.0: A Lightweight Unified Multimodal Model for Advancing Image Generation and Editing(DeepGen 1.0:一个用于推进图像生成与编辑的轻量级统一多模态模型)
[] 🧩 Composition-RL: Compose Your Verifiable Prompts for Reinforcement Learning of Large Language Models(Composition-RL:为大型语言模型强化学习组合可验证提示)
[] 🧠 Thinking with Drafting: Optical Decompression via Logical Reconstruction(思维与草稿:通过逻辑重构实现光学解压缩)
[] 🗳 dVoting: Fast Voting for dLLMs(dVoting:面向扩散大语言模型的快速投票推理方法)
[] 🤖 RISE: Self-Improving Robot Policy with Compositional World Model(RISE:基于组合世界模型的机器人策略自改进框架)
[] 🤖 $χ_{0}$: Resource-Aware Robust Manipulation via Taming Distributional Inconsistencies(χ₀:通过驯服分布不一致实现资源感知的鲁棒机器人操作)
[] 🤖 EgoHumanoid: Unlocking In-the-Wild Loco-Manipulation with Robot-Free Egocentric Demonstration(EgoHumanoid:利用无机器人自我中心演示解锁野外移动操作)
[] 🔍 Unveiling Implicit Advantage Symmetry: Why GRPO Struggles with Exploration and Difficulty Adaptation(揭示隐式优势对称性:为何GRPO在探索与难度适应中举步维艰)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2 月 14 日 · 13 分钟
【赞助商】
通勤路上就听AI每周谈。AI每周谈,每周带你回顾上周AI大事
传送门 🔗https://www.xiaoyuzhoufm.com/podcast/688a34636f5a275f1cba40fd
【目录】
本期的 15 篇论文如下:
[] ⚠ The Devil Behind Moltbook: Anthropic Safety is Always Vanishing in Self-Evolving AI Societies(魔书背后的魔鬼:在自我进化的AI社会中,人类安全价值总是趋于消失)
[] 🎵 MOSS-Audio-Tokenizer: Scaling Audio Tokenizers for Future Audio Foundation Models(MOSS-Audio-Tokenizer:为未来音频基础模型扩展音频分词器)
[] 🧠 Learning beyond Teacher: Generalized On-Policy Distillation with Reward Extrapolation(超越教师的学习:基于奖励外推的广义策略蒸馏)
[] 🤖 GigaBrain-0.5M*: a VLA That Learns From World Model-Based Reinforcement Learning(GigaBrain-0.5M*:一种通过世界模型强化学习训练的视觉-语言-动作模型)
[] ⚖ LawThinker: A Deep Research Legal Agent in Dynamic Environments(LawThinker:动态环境中的深度研究法律智能体)
[] 🔍 Think Longer to Explore Deeper: Learn to Explore In-Context via Length-Incentivized Reinforcement Learning(思之愈久,探之愈深:通过长度激励强化学习实现上下文内探索)
[] 🎨 Stroke of Surprise: Progressive Semantic Illusions in Vector Sketching(惊喜之笔:矢量草图绘制中的渐进式语义错觉)
[] 🚀 DeepGen 1.0: A Lightweight Unified Multimodal Model for Advancing Image Generation and Editing(DeepGen 1.0:一个用于推进图像生成与编辑的轻量级统一多模态模型)
[] 🧩 Composition-RL: Compose Your Verifiable Prompts for Reinforcement Learning of Large Language Models(Composition-RL:为大型语言模型强化学习组合可验证提示)
[] 🧠 Thinking with Drafting: Optical Decompression via Logical Reconstruction(思维与草稿:通过逻辑重构实现光学解压缩)
[] 🗳 dVoting: Fast Voting for dLLMs(dVoting:面向扩散大语言模型的快速投票推理方法)
[] 🤖 RISE: Self-Improving Robot Policy with Compositional World Model(RISE:基于组合世界模型的机器人策略自改进框架)
[] 🤖 $χ_{0}$: Resource-Aware Robust Manipulation via Taming Distributional Inconsistencies(χ₀:通过驯服分布不一致实现资源感知的鲁棒机器人操作)
[] 🤖 EgoHumanoid: Unlocking In-the-Wild Loco-Manipulation with Robot-Free Egocentric Demonstration(EgoHumanoid:利用无机器人自我中心演示解锁野外移动操作)
[] 🔍 Unveiling Implicit Advantage Symmetry: Why GRPO Struggles with Exploration and Difficulty Adaptation(揭示隐式优势对称性:为何GRPO在探索与难度适应中举步维艰)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟