H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

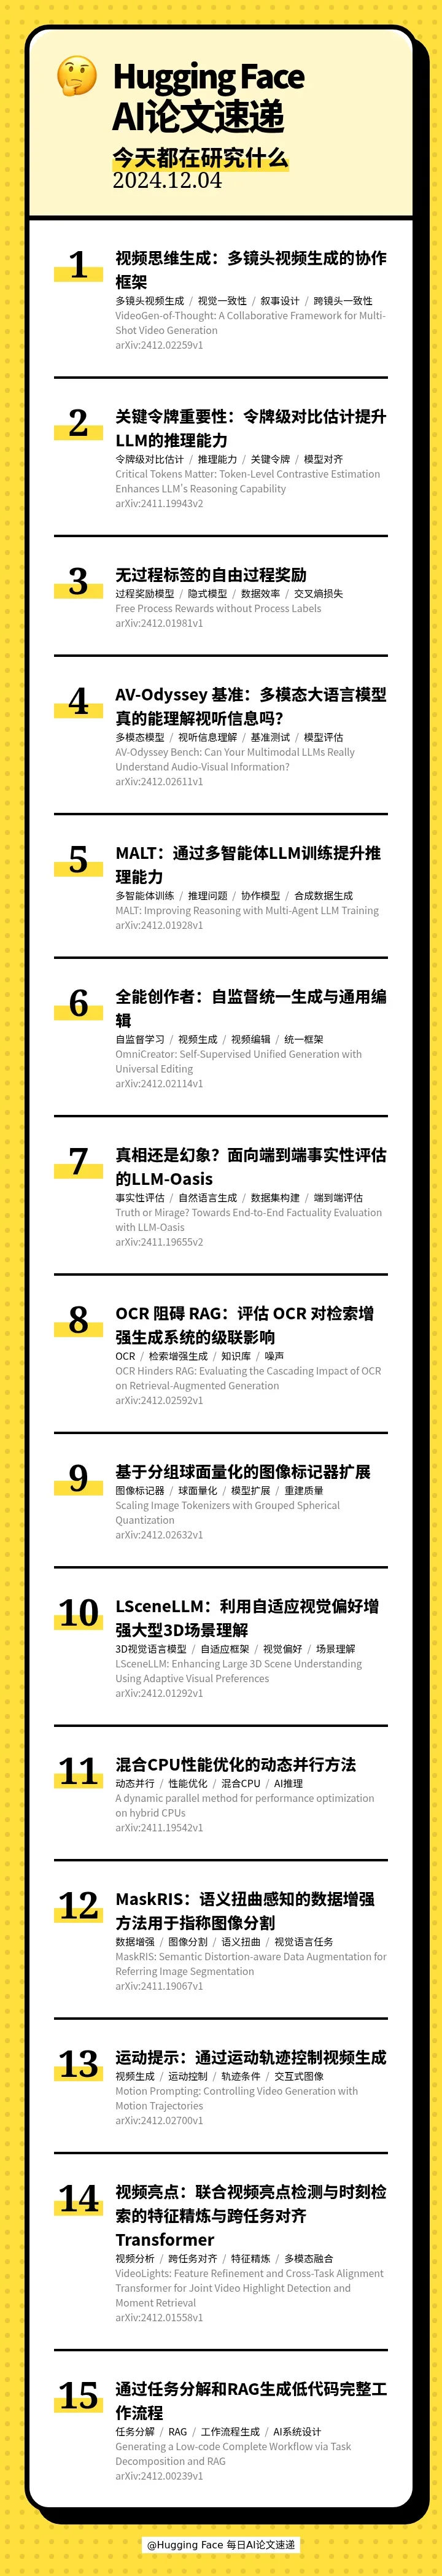
本期的 15 篇论文如下:
[] 🎥 VideoGen-of-Thought: A Collaborative Framework for Multi-Shot Video Generation(视频思维生成:多镜头视频生成的协作框架)
[] 🧠 Critical Tokens Matter: Token-Level Contrastive Estimation Enhances LLM's Reasoning Capability(关键令牌重要性:令牌级对比估计提升LLM的推理能力)
[] 🔄 Free Process Rewards without Process Labels(无过程标签的自由过程奖励)
[] 🎧 AV-Odyssey Bench: Can Your Multimodal LLMs Really Understand Audio-Visual Information?(AV-Odyssey 基准:多模态大语言模型真的能理解视听信息吗?)
[] 🤖 MALT: Improving Reasoning with Multi-Agent LLM Training(MALT:通过多智能体LLM训练提升推理能力)
[] 🎥 OmniCreator: Self-Supervised Unified Generation with Universal Editing(全能创作者:自监督统一生成与通用编辑)
[] 🌴 Truth or Mirage? Towards End-to-End Factuality Evaluation with LLM-Oasis(真相还是幻象?面向端到端事实性评估的LLM-Oasis)
[] 📚 OCR Hinders RAG: Evaluating the Cascading Impact of OCR on Retrieval-Augmented Generation(OCR 阻碍 RAG:评估 OCR 对检索增强生成系统的级联影响)
[] 📊 Scaling Image Tokenizers with Grouped Spherical Quantization(基于分组球面量化的图像标记器扩展)
[] 🌐 LSceneLLM: Enhancing Large 3D Scene Understanding Using Adaptive Visual Preferences(LSceneLLM:利用自适应视觉偏好增强大型3D场景理解)
[] ⚙ A dynamic parallel method for performance optimization on hybrid CPUs(混合CPU性能优化的动态并行方法)
[] 🌐 MaskRIS: Semantic Distortion-aware Data Augmentation for Referring Image Segmentation(MaskRIS:语义扭曲感知的数据增强方法用于指称图像分割)
[] 🎥 Motion Prompting: Controlling Video Generation with Motion Trajectories(运动提示:通过运动轨迹控制视频生成)
[] 🎥 VideoLights: Feature Refinement and Cross-Task Alignment Transformer for Joint Video Highlight Detection and Moment Retrieval(视频亮点:联合视频亮点检测与时刻检索的特征精炼与跨任务对齐Transformer)
[] 🤖 Generating a Low-code Complete Workflow via Task Decomposition and RAG(通过任务分解和RAG生成低代码完整工作流程)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2024 年 12 月 5 日 · 11 分钟
本期的 15 篇论文如下:
[] 🎥 VideoGen-of-Thought: A Collaborative Framework for Multi-Shot Video Generation(视频思维生成:多镜头视频生成的协作框架)
[] 🧠 Critical Tokens Matter: Token-Level Contrastive Estimation Enhances LLM's Reasoning Capability(关键令牌重要性:令牌级对比估计提升LLM的推理能力)
[] 🔄 Free Process Rewards without Process Labels(无过程标签的自由过程奖励)
[] 🎧 AV-Odyssey Bench: Can Your Multimodal LLMs Really Understand Audio-Visual Information?(AV-Odyssey 基准:多模态大语言模型真的能理解视听信息吗?)
[] 🤖 MALT: Improving Reasoning with Multi-Agent LLM Training(MALT:通过多智能体LLM训练提升推理能力)
[] 🎥 OmniCreator: Self-Supervised Unified Generation with Universal Editing(全能创作者:自监督统一生成与通用编辑)
[] 🌴 Truth or Mirage? Towards End-to-End Factuality Evaluation with LLM-Oasis(真相还是幻象?面向端到端事实性评估的LLM-Oasis)
[] 📚 OCR Hinders RAG: Evaluating the Cascading Impact of OCR on Retrieval-Augmented Generation(OCR 阻碍 RAG:评估 OCR 对检索增强生成系统的级联影响)
[] 📊 Scaling Image Tokenizers with Grouped Spherical Quantization(基于分组球面量化的图像标记器扩展)
[] 🌐 LSceneLLM: Enhancing Large 3D Scene Understanding Using Adaptive Visual Preferences(LSceneLLM:利用自适应视觉偏好增强大型3D场景理解)
[] ⚙ A dynamic parallel method for performance optimization on hybrid CPUs(混合CPU性能优化的动态并行方法)
[] 🌐 MaskRIS: Semantic Distortion-aware Data Augmentation for Referring Image Segmentation(MaskRIS:语义扭曲感知的数据增强方法用于指称图像分割)
[] 🎥 Motion Prompting: Controlling Video Generation with Motion Trajectories(运动提示:通过运动轨迹控制视频生成)
[] 🎥 VideoLights: Feature Refinement and Cross-Task Alignment Transformer for Joint Video Highlight Detection and Moment Retrieval(视频亮点:联合视频亮点检测与时刻检索的特征精炼与跨任务对齐Transformer)
[] 🤖 Generating a Low-code Complete Workflow via Task Decomposition and RAG(通过任务分解和RAG生成低代码完整工作流程)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟