H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 15 篇论文如下:
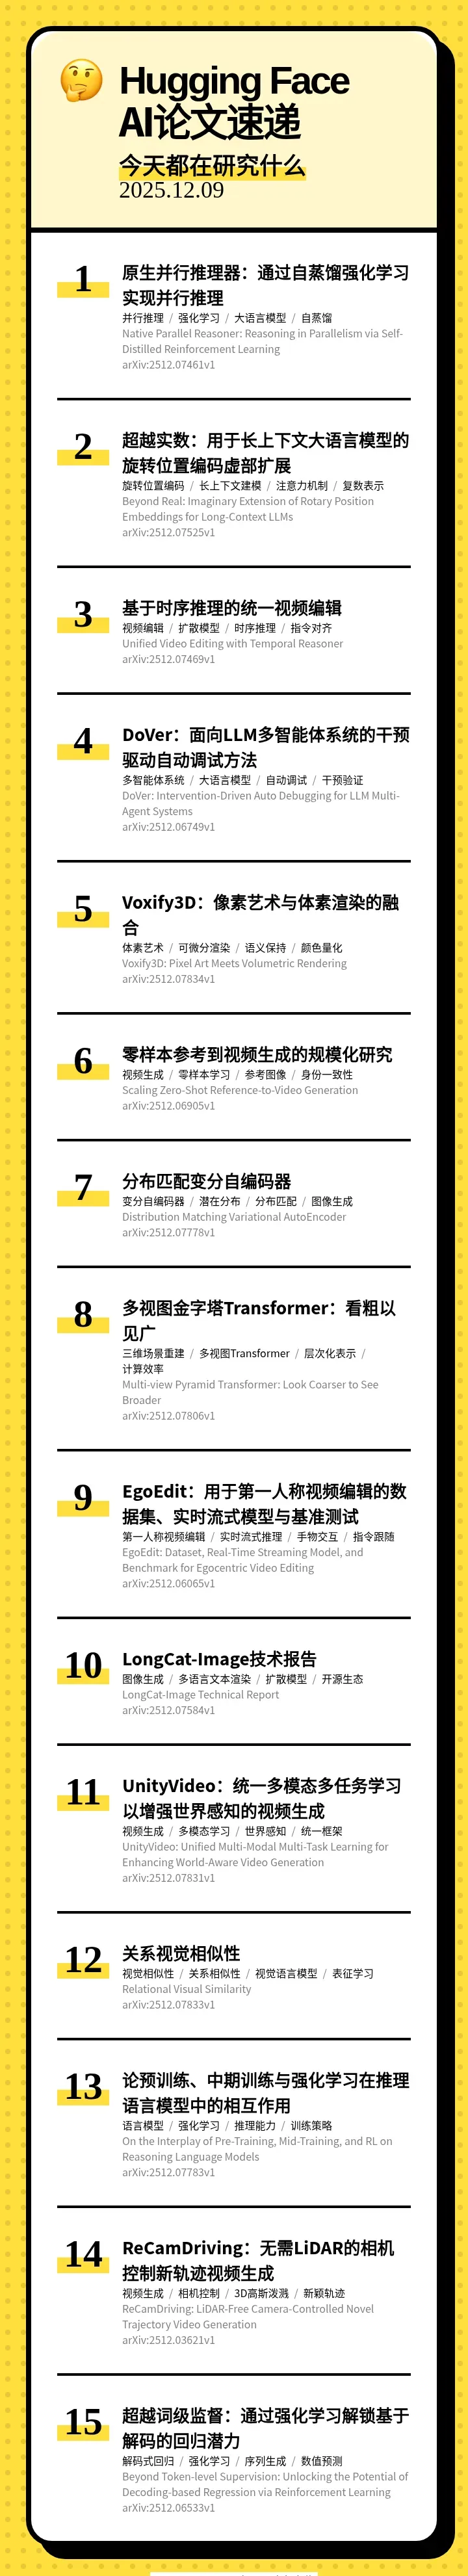
[] ⚡ Native Parallel Reasoner: Reasoning in Parallelism via Self-Distilled Reinforcement Learning(原生并行推理器:通过自蒸馏强化学习实现并行推理)
[] 🧠 Beyond Real: Imaginary Extension of Rotary Position Embeddings for Long-Context LLMs(超越实数:用于长上下文大语言模型的旋转位置编码虚部扩展)
[] 🎬 Unified Video Editing with Temporal Reasoner(基于时序推理的统一视频编辑)
[] 🔍 DoVer: Intervention-Driven Auto Debugging for LLM Multi-Agent Systems(DoVer:面向LLM多智能体系统的干预驱动自动调试方法)
[] 🎮 Voxify3D: Pixel Art Meets Volumetric Rendering(Voxify3D:像素艺术与体素渲染的融合)
[] 🎬 Scaling Zero-Shot Reference-to-Video Generation(零样本参考到视频生成的规模化研究)
[] 🧬 Distribution Matching Variational AutoEncoder(分布匹配变分自编码器)
[] 🔭 Multi-view Pyramid Transformer: Look Coarser to See Broader(多视图金字塔Transformer:看粗以见广)
[] 🎬 EgoEdit: Dataset, Real-Time Streaming Model, and Benchmark for Egocentric Video Editing(EgoEdit:用于第一人称视频编辑的数据集、实时流式模型与基准测试)
[] 🖼 LongCat-Image Technical Report(LongCat-Image技术报告)
[] 🎬 UnityVideo: Unified Multi-Modal Multi-Task Learning for Enhancing World-Aware Video Generation(UnityVideo:统一多模态多任务学习以增强世界感知的视频生成)
[] 🔗 Relational Visual Similarity(关系视觉相似性)
[] 🔬 On the Interplay of Pre-Training, Mid-Training, and RL on Reasoning Language Models(论预训练、中期训练与强化学习在推理语言模型中的相互作用)
[] 🎥 ReCamDriving: LiDAR-Free Camera-Controlled Novel Trajectory Video Generation(ReCamDriving:无需LiDAR的相机控制新轨迹视频生成)
[] 🚀 Beyond Token-level Supervision: Unlocking the Potential of Decoding-based Regression via Reinforcement Learning(超越词级监督:通过强化学习解锁基于解码的回归潜力)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 12 月 10 日 · 11 分钟
本期的 15 篇论文如下:
[] ⚡ Native Parallel Reasoner: Reasoning in Parallelism via Self-Distilled Reinforcement Learning(原生并行推理器:通过自蒸馏强化学习实现并行推理)
[] 🧠 Beyond Real: Imaginary Extension of Rotary Position Embeddings for Long-Context LLMs(超越实数:用于长上下文大语言模型的旋转位置编码虚部扩展)
[] 🎬 Unified Video Editing with Temporal Reasoner(基于时序推理的统一视频编辑)
[] 🔍 DoVer: Intervention-Driven Auto Debugging for LLM Multi-Agent Systems(DoVer:面向LLM多智能体系统的干预驱动自动调试方法)
[] 🎮 Voxify3D: Pixel Art Meets Volumetric Rendering(Voxify3D:像素艺术与体素渲染的融合)
[] 🎬 Scaling Zero-Shot Reference-to-Video Generation(零样本参考到视频生成的规模化研究)
[] 🧬 Distribution Matching Variational AutoEncoder(分布匹配变分自编码器)
[] 🔭 Multi-view Pyramid Transformer: Look Coarser to See Broader(多视图金字塔Transformer:看粗以见广)
[] 🎬 EgoEdit: Dataset, Real-Time Streaming Model, and Benchmark for Egocentric Video Editing(EgoEdit:用于第一人称视频编辑的数据集、实时流式模型与基准测试)
[] 🖼 LongCat-Image Technical Report(LongCat-Image技术报告)
[] 🎬 UnityVideo: Unified Multi-Modal Multi-Task Learning for Enhancing World-Aware Video Generation(UnityVideo:统一多模态多任务学习以增强世界感知的视频生成)
[] 🔗 Relational Visual Similarity(关系视觉相似性)
[] 🔬 On the Interplay of Pre-Training, Mid-Training, and RL on Reasoning Language Models(论预训练、中期训练与强化学习在推理语言模型中的相互作用)
[] 🎥 ReCamDriving: LiDAR-Free Camera-Controlled Novel Trajectory Video Generation(ReCamDriving:无需LiDAR的相机控制新轨迹视频生成)
[] 🚀 Beyond Token-level Supervision: Unlocking the Potential of Decoding-based Regression via Reinforcement Learning(超越词级监督:通过强化学习解锁基于解码的回归潜力)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟