H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 12 篇论文如下:
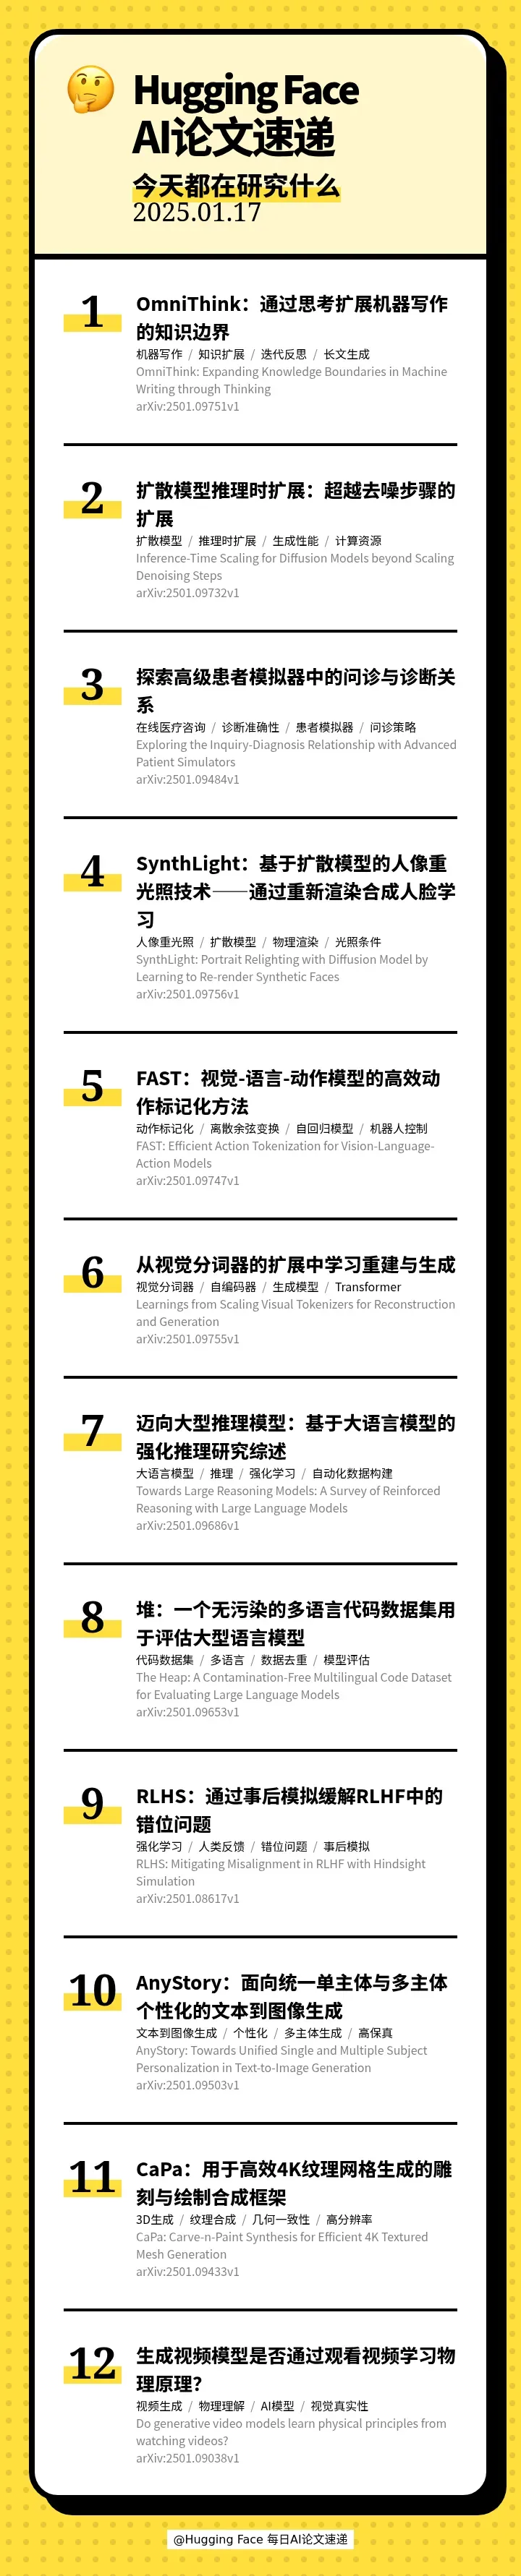
[] 🧠 OmniThink: Expanding Knowledge Boundaries in Machine Writing through Thinking(OmniThink:通过思考扩展机器写作的知识边界)
[] 🔍 Inference-Time Scaling for Diffusion Models beyond Scaling Denoising Steps(扩散模型推理时扩展:超越去噪步骤的扩展)
[] 🩺 Exploring the Inquiry-Diagnosis Relationship with Advanced Patient Simulators(探索高级患者模拟器中的问诊与诊断关系)
[] 🎨 SynthLight: Portrait Relighting with Diffusion Model by Learning to Re-render Synthetic Faces(SynthLight:基于扩散模型的人像重光照技术——通过重新渲染合成人脸学习)
[] 🤖 FAST: Efficient Action Tokenization for Vision-Language-Action Models(FAST:视觉-语言-动作模型的高效动作标记化方法)
[] 🔍 Learnings from Scaling Visual Tokenizers for Reconstruction and Generation(从视觉分词器的扩展中学习重建与生成)
[] 🧠 Towards Large Reasoning Models: A Survey of Reinforced Reasoning with Large Language Models(迈向大型推理模型:基于大语言模型的强化推理研究综述)
[] 🧹 The Heap: A Contamination-Free Multilingual Code Dataset for Evaluating Large Language Models(堆:一个无污染的多语言代码数据集用于评估大型语言模型)
[] 🤖 RLHS: Mitigating Misalignment in RLHF with Hindsight Simulation(RLHS:通过事后模拟缓解RLHF中的错位问题)
[] 🎨 AnyStory: Towards Unified Single and Multiple Subject Personalization in Text-to-Image Generation(AnyStory:面向统一单主体与多主体个性化的文本到图像生成)
[] 🎨 CaPa: Carve-n-Paint Synthesis for Efficient 4K Textured Mesh Generation(CaPa:用于高效4K纹理网格生成的雕刻与绘制合成框架)
[] 🎥 Do generative video models learn physical principles from watching videos?(生成视频模型是否通过观看视频学习物理原理?)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 1 月 18 日 · 8 分钟
本期的 12 篇论文如下:
[] 🧠 OmniThink: Expanding Knowledge Boundaries in Machine Writing through Thinking(OmniThink:通过思考扩展机器写作的知识边界)
[] 🔍 Inference-Time Scaling for Diffusion Models beyond Scaling Denoising Steps(扩散模型推理时扩展:超越去噪步骤的扩展)
[] 🩺 Exploring the Inquiry-Diagnosis Relationship with Advanced Patient Simulators(探索高级患者模拟器中的问诊与诊断关系)
[] 🎨 SynthLight: Portrait Relighting with Diffusion Model by Learning to Re-render Synthetic Faces(SynthLight:基于扩散模型的人像重光照技术——通过重新渲染合成人脸学习)
[] 🤖 FAST: Efficient Action Tokenization for Vision-Language-Action Models(FAST:视觉-语言-动作模型的高效动作标记化方法)
[] 🔍 Learnings from Scaling Visual Tokenizers for Reconstruction and Generation(从视觉分词器的扩展中学习重建与生成)
[] 🧠 Towards Large Reasoning Models: A Survey of Reinforced Reasoning with Large Language Models(迈向大型推理模型:基于大语言模型的强化推理研究综述)
[] 🧹 The Heap: A Contamination-Free Multilingual Code Dataset for Evaluating Large Language Models(堆:一个无污染的多语言代码数据集用于评估大型语言模型)
[] 🤖 RLHS: Mitigating Misalignment in RLHF with Hindsight Simulation(RLHS:通过事后模拟缓解RLHF中的错位问题)
[] 🎨 AnyStory: Towards Unified Single and Multiple Subject Personalization in Text-to-Image Generation(AnyStory:面向统一单主体与多主体个性化的文本到图像生成)
[] 🎨 CaPa: Carve-n-Paint Synthesis for Efficient 4K Textured Mesh Generation(CaPa:用于高效4K纹理网格生成的雕刻与绘制合成框架)
[] 🎥 Do generative video models learn physical principles from watching videos?(生成视频模型是否通过观看视频学习物理原理?)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟