H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

【目录】
本期的 15 篇论文如下:
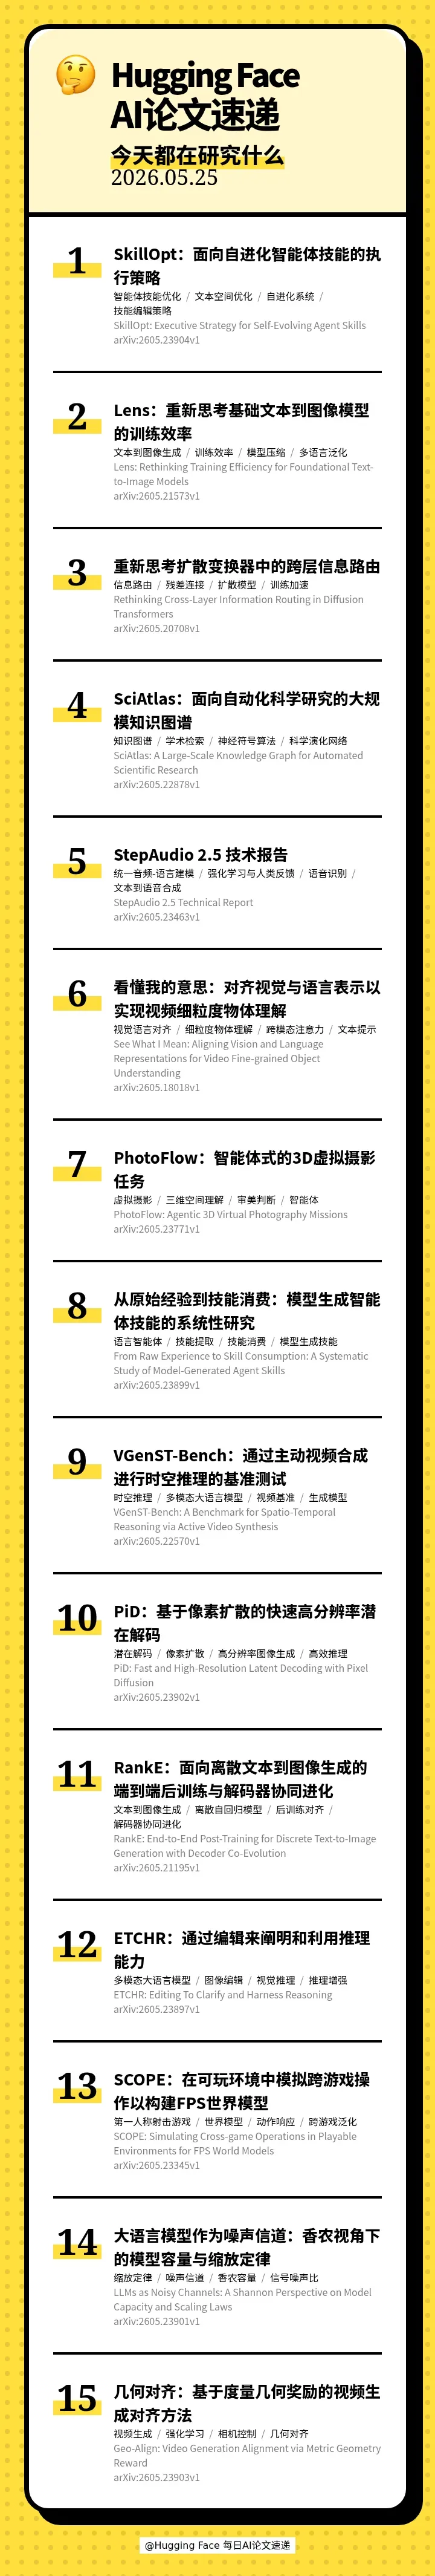
[] 🧠 SkillOpt: Executive Strategy for Self-Evolving Agent Skills(SkillOpt:面向自进化智能体技能的执行策略)
[] 🔍 Lens: Rethinking Training Efficiency for Foundational Text-to-Image Models(Lens:重新思考基础文本到图像模型的训练效率)
[] 🔀 Rethinking Cross-Layer Information Routing in Diffusion Transformers(重新思考扩散变换器中的跨层信息路由)
[] 🧠 SciAtlas: A Large-Scale Knowledge Graph for Automated Scientific Research(SciAtlas:面向自动化科学研究的大规模知识图谱)
[] 🎙 StepAudio 2.5 Technical Report(StepAudio 2.5 技术报告)
[] 👁 See What I Mean: Aligning Vision and Language Representations for Video Fine-grained Object Understanding(看懂我的意思:对齐视觉与语言表示以实现视频细粒度物体理解)
[] 📸 PhotoFlow: Agentic 3D Virtual Photography Missions(PhotoFlow:智能体式的3D虚拟摄影任务)
[] 🧠 From Raw Experience to Skill Consumption: A Systematic Study of Model-Generated Agent Skills(从原始经验到技能消费:模型生成智能体技能的系统性研究)
[] 🎥 VGenST-Bench: A Benchmark for Spatio-Temporal Reasoning via Active Video Synthesis(VGenST-Bench:通过主动视频合成进行时空推理的基准测试)
[] ⚡ PiD: Fast and High-Resolution Latent Decoding with Pixel Diffusion(PiD:基于像素扩散的快速高分辨率潜在解码)
[] 🎨 RankE: End-to-End Post-Training for Discrete Text-to-Image Generation with Decoder Co-Evolution(RankE:面向离散文本到图像生成的端到端后训练与解码器协同进化)
[] ✂ ETCHR: Editing To Clarify and Harness Reasoning(ETCHR:通过编辑来阐明和利用推理能力)
[] 🎮 SCOPE: Simulating Cross-game Operations in Playable Environments for FPS World Models(SCOPE:在可玩环境中模拟跨游戏操作以构建FPS世界模型)
[] 📡 LLMs as Noisy Channels: A Shannon Perspective on Model Capacity and Scaling Laws(大语言模型作为噪声信道:香农视角下的模型容量与缩放定律)
[] 🎥 Geo-Align: Video Generation Alignment via Metric Geometry Reward(几何对齐:基于度量几何奖励的视频生成对齐方法)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 5 月 26 日 · 15 分钟
【目录】
本期的 15 篇论文如下:
[] 🧠 SkillOpt: Executive Strategy for Self-Evolving Agent Skills(SkillOpt:面向自进化智能体技能的执行策略)
[] 🔍 Lens: Rethinking Training Efficiency for Foundational Text-to-Image Models(Lens:重新思考基础文本到图像模型的训练效率)
[] 🔀 Rethinking Cross-Layer Information Routing in Diffusion Transformers(重新思考扩散变换器中的跨层信息路由)
[] 🧠 SciAtlas: A Large-Scale Knowledge Graph for Automated Scientific Research(SciAtlas:面向自动化科学研究的大规模知识图谱)
[] 🎙 StepAudio 2.5 Technical Report(StepAudio 2.5 技术报告)
[] 👁 See What I Mean: Aligning Vision and Language Representations for Video Fine-grained Object Understanding(看懂我的意思:对齐视觉与语言表示以实现视频细粒度物体理解)
[] 📸 PhotoFlow: Agentic 3D Virtual Photography Missions(PhotoFlow:智能体式的3D虚拟摄影任务)
[] 🧠 From Raw Experience to Skill Consumption: A Systematic Study of Model-Generated Agent Skills(从原始经验到技能消费:模型生成智能体技能的系统性研究)
[] 🎥 VGenST-Bench: A Benchmark for Spatio-Temporal Reasoning via Active Video Synthesis(VGenST-Bench:通过主动视频合成进行时空推理的基准测试)
[] ⚡ PiD: Fast and High-Resolution Latent Decoding with Pixel Diffusion(PiD:基于像素扩散的快速高分辨率潜在解码)
[] 🎨 RankE: End-to-End Post-Training for Discrete Text-to-Image Generation with Decoder Co-Evolution(RankE:面向离散文本到图像生成的端到端后训练与解码器协同进化)
[] ✂ ETCHR: Editing To Clarify and Harness Reasoning(ETCHR:通过编辑来阐明和利用推理能力)
[] 🎮 SCOPE: Simulating Cross-game Operations in Playable Environments for FPS World Models(SCOPE:在可玩环境中模拟跨游戏操作以构建FPS世界模型)
[] 📡 LLMs as Noisy Channels: A Shannon Perspective on Model Capacity and Scaling Laws(大语言模型作为噪声信道:香农视角下的模型容量与缩放定律)
[] 🎥 Geo-Align: Video Generation Alignment via Metric Geometry Reward(几何对齐:基于度量几何奖励的视频生成对齐方法)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟