H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 15 篇论文如下:
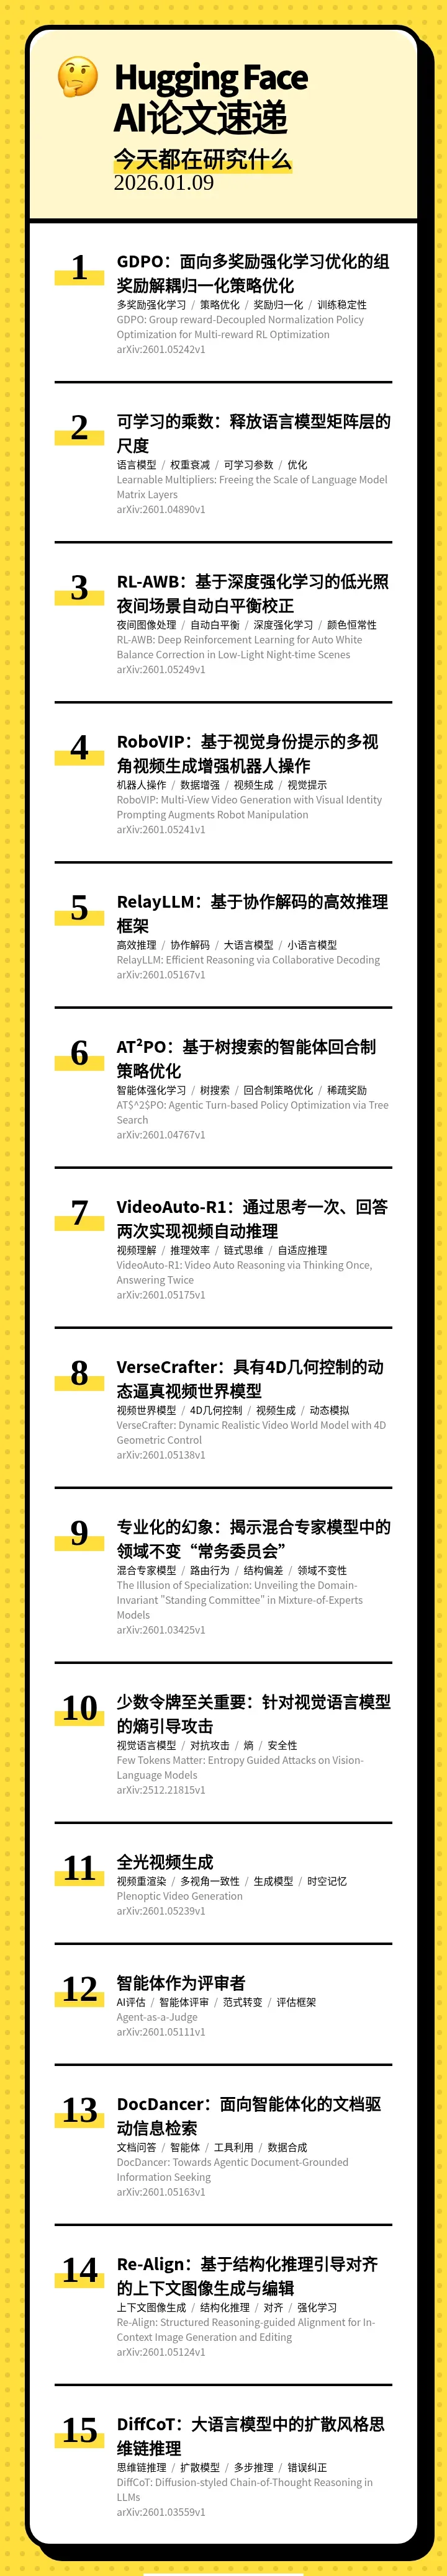
[] 📈 GDPO: Group reward-Decoupled Normalization Policy Optimization for Multi-reward RL Optimization(GDPO:面向多奖励强化学习优化的组奖励解耦归一化策略优化)
[] ⚖ Learnable Multipliers: Freeing the Scale of Language Model Matrix Layers(可学习的乘数:释放语言模型矩阵层的尺度)
[] 🌙 RL-AWB: Deep Reinforcement Learning for Auto White Balance Correction in Low-Light Night-time Scenes(RL-AWB:基于深度强化学习的低光照夜间场景自动白平衡校正)
[] 🤖 RoboVIP: Multi-View Video Generation with Visual Identity Prompting Augments Robot Manipulation(RoboVIP:基于视觉身份提示的多视角视频生成增强机器人操作)
[] 🤝 RelayLLM: Efficient Reasoning via Collaborative Decoding(RelayLLM:基于协作解码的高效推理框架)
[] 🌲 AT$^2$PO: Agentic Turn-based Policy Optimization via Tree Search(AT²PO:基于树搜索的智能体回合制策略优化)
[] 🤔 VideoAuto-R1: Video Auto Reasoning via Thinking Once, Answering Twice(VideoAuto-R1:通过思考一次、回答两次实现视频自动推理)
[] 🎬 VerseCrafter: Dynamic Realistic Video World Model with 4D Geometric Control(VerseCrafter:具有4D几何控制的动态逼真视频世界模型)
[] 🔍 The Illusion of Specialization: Unveiling the Domain-Invariant "Standing Committee" in Mixture-of-Experts Models(专业化的幻象:揭示混合专家模型中的领域不变“常务委员会”)
[] 🎯 Few Tokens Matter: Entropy Guided Attacks on Vision-Language Models(少数令牌至关重要:针对视觉语言模型的熵引导攻击)
[] 🎥 Plenoptic Video Generation(全光视频生成)
[] ⚖ Agent-as-a-Judge(智能体作为评审者)
[] 📄 DocDancer: Towards Agentic Document-Grounded Information Seeking(DocDancer:面向智能体化的文档驱动信息检索)
[] 🧠 Re-Align: Structured Reasoning-guided Alignment for In-Context Image Generation and Editing(Re-Align:基于结构化推理引导对齐的上下文图像生成与编辑)
[] 🧠 DiffCoT: Diffusion-styled Chain-of-Thought Reasoning in LLMs(DiffCoT:大语言模型中的扩散风格思维链推理)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 1 月 10 日 · 10 分钟
本期的 15 篇论文如下:
[] 📈 GDPO: Group reward-Decoupled Normalization Policy Optimization for Multi-reward RL Optimization(GDPO:面向多奖励强化学习优化的组奖励解耦归一化策略优化)
[] ⚖ Learnable Multipliers: Freeing the Scale of Language Model Matrix Layers(可学习的乘数:释放语言模型矩阵层的尺度)
[] 🌙 RL-AWB: Deep Reinforcement Learning for Auto White Balance Correction in Low-Light Night-time Scenes(RL-AWB:基于深度强化学习的低光照夜间场景自动白平衡校正)
[] 🤖 RoboVIP: Multi-View Video Generation with Visual Identity Prompting Augments Robot Manipulation(RoboVIP:基于视觉身份提示的多视角视频生成增强机器人操作)
[] 🤝 RelayLLM: Efficient Reasoning via Collaborative Decoding(RelayLLM:基于协作解码的高效推理框架)
[] 🌲 AT$^2$PO: Agentic Turn-based Policy Optimization via Tree Search(AT²PO:基于树搜索的智能体回合制策略优化)
[] 🤔 VideoAuto-R1: Video Auto Reasoning via Thinking Once, Answering Twice(VideoAuto-R1:通过思考一次、回答两次实现视频自动推理)
[] 🎬 VerseCrafter: Dynamic Realistic Video World Model with 4D Geometric Control(VerseCrafter:具有4D几何控制的动态逼真视频世界模型)
[] 🔍 The Illusion of Specialization: Unveiling the Domain-Invariant "Standing Committee" in Mixture-of-Experts Models(专业化的幻象:揭示混合专家模型中的领域不变“常务委员会”)
[] 🎯 Few Tokens Matter: Entropy Guided Attacks on Vision-Language Models(少数令牌至关重要:针对视觉语言模型的熵引导攻击)
[] 🎥 Plenoptic Video Generation(全光视频生成)
[] ⚖ Agent-as-a-Judge(智能体作为评审者)
[] 📄 DocDancer: Towards Agentic Document-Grounded Information Seeking(DocDancer:面向智能体化的文档驱动信息检索)
[] 🧠 Re-Align: Structured Reasoning-guided Alignment for In-Context Image Generation and Editing(Re-Align:基于结构化推理引导对齐的上下文图像生成与编辑)
[] 🧠 DiffCoT: Diffusion-styled Chain-of-Thought Reasoning in LLMs(DiffCoT:大语言模型中的扩散风格思维链推理)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟