H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 23 篇论文如下:
[] 🎥 InternLM-XComposer2.5-OmniLive: A Comprehensive Multimodal System for Long-term Streaming Video and Audio Interactions(InternLM-XComposer2.5-OmniLive:一个用于长期流式视频和音频交互的综合多模态系统)
[] 🧠 Phi-4 Technical Report(Phi-4 技术报告)
[] 🧠 Euclid: Supercharging Multimodal LLMs with Synthetic High-Fidelity Visual Descriptions(欧几里得:通过合成高保真视觉描述提升多模态大语言模型)
[] 🌐 Multimodal Latent Language Modeling with Next-Token Diffusion(多模态潜在语言建模与下一词扩散)
[] 🌐 EasyRef: Omni-Generalized Group Image Reference for Diffusion Models via Multimodal LLM(EasyRef:基于多模态大语言模型的扩散模型通用化图像参考)
[] 🌐 AgentTrek: Agent Trajectory Synthesis via Guiding Replay with Web Tutorials(AgentTrek:通过网络教程引导回放的代理轨迹合成)
[] 🌟 Neural LightRig: Unlocking Accurate Object Normal and Material Estimation with Multi-Light Diffusion(神经光装置:利用多光源扩散解锁精确物体法线和材质估计)
[] 📱 SnapGen: Taming High-Resolution Text-to-Image Models for Mobile Devices with Efficient Architectures and Training(SnapGen:通过高效架构和训练驯服高分辨率文本到图像模型以适应移动设备)
[] 🔬 PIG: Physics-Informed Gaussians as Adaptive Parametric Mesh Representations(PIG:物理信息高斯函数作为自适应参数化网格表示)
[] 📊 Learned Compression for Compressed Learning(压缩学习中的学习压缩)
[] 🎙 Lyra: An Efficient and Speech-Centric Framework for Omni-Cognition(Lyra:一个高效且以语音为中心的全认知框架)
[] 📊 RuleArena: A Benchmark for Rule-Guided Reasoning with LLMs in Real-World Scenarios(RuleArena:在现实场景中评估LLMs规则引导推理能力的基准)
[] 👀 Gaze-LLE: Gaze Target Estimation via Large-Scale Learned Encoders(Gaze-LLE:通过大规模学习编码器进行注视目标估计)
[] 🧠 JuStRank: Benchmarking LLM Judges for System Ranking(JuStRank:基准测试用于系统排名的LLM评判器)
[] 🧠 OLA-VLM: Elevating Visual Perception in Multimodal LLMs with Auxiliary Embedding Distillation(OLA-VLM:通过辅助嵌入蒸馏提升多模态大语言模型的视觉感知能力)
[] 📚 The Impact of Copyrighted Material on Large Language Models: A Norwegian Perspective(版权材料对大型语言模型的影响:挪威视角)
[] 🔗 Word Sense Linking: Disambiguating Outside the Sandbox(词义链接:超越沙盒的消歧)
[] 🌐 FreeSplatter: Pose-free Gaussian Splatting for Sparse-view 3D Reconstruction(FreeSplatter:无姿态高斯喷射用于稀疏视图三维重建)
[] 🎥 DisPose: Disentangling Pose Guidance for Controllable Human Image Animation(DisPose:解耦姿态引导的可控人体图像动画)
[] 🖼 LoRACLR: Contrastive Adaptation for Customization of Diffusion Models(LoRACLR:对比适应用于扩散模型的定制化)
[] 🧭 SAME: Learning Generic Language-Guided Visual Navigation with State-Adaptive Mixture of Experts(SAME:学习基于状态自适应混合专家的通用语言引导视觉导航)
[] 🌟 Arbitrary-steps Image Super-resolution via Diffusion Inversion(基于扩散反演的任意步图像超分辨率)
[] 📚 Shiksha: A Technical Domain focused Translation Dataset and Model for Indian Languages(Shiksha:面向印度语言的技术领域翻译数据集与模型)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2024 年 12 月 14 日 · 18 分钟
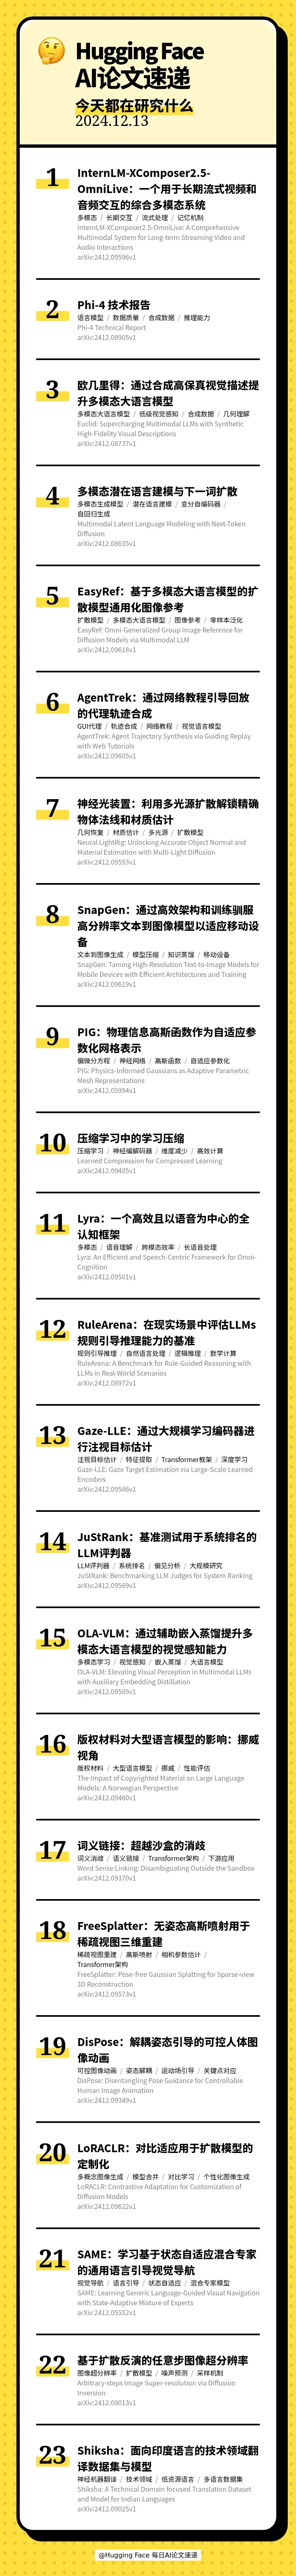
本期的 23 篇论文如下:
[] 🎥 InternLM-XComposer2.5-OmniLive: A Comprehensive Multimodal System for Long-term Streaming Video and Audio Interactions(InternLM-XComposer2.5-OmniLive:一个用于长期流式视频和音频交互的综合多模态系统)
[] 🧠 Phi-4 Technical Report(Phi-4 技术报告)
[] 🧠 Euclid: Supercharging Multimodal LLMs with Synthetic High-Fidelity Visual Descriptions(欧几里得:通过合成高保真视觉描述提升多模态大语言模型)
[] 🌐 Multimodal Latent Language Modeling with Next-Token Diffusion(多模态潜在语言建模与下一词扩散)
[] 🌐 EasyRef: Omni-Generalized Group Image Reference for Diffusion Models via Multimodal LLM(EasyRef:基于多模态大语言模型的扩散模型通用化图像参考)
[] 🌐 AgentTrek: Agent Trajectory Synthesis via Guiding Replay with Web Tutorials(AgentTrek:通过网络教程引导回放的代理轨迹合成)
[] 🌟 Neural LightRig: Unlocking Accurate Object Normal and Material Estimation with Multi-Light Diffusion(神经光装置:利用多光源扩散解锁精确物体法线和材质估计)
[] 📱 SnapGen: Taming High-Resolution Text-to-Image Models for Mobile Devices with Efficient Architectures and Training(SnapGen:通过高效架构和训练驯服高分辨率文本到图像模型以适应移动设备)
[] 🔬 PIG: Physics-Informed Gaussians as Adaptive Parametric Mesh Representations(PIG:物理信息高斯函数作为自适应参数化网格表示)
[] 📊 Learned Compression for Compressed Learning(压缩学习中的学习压缩)
[] 🎙 Lyra: An Efficient and Speech-Centric Framework for Omni-Cognition(Lyra:一个高效且以语音为中心的全认知框架)
[] 📊 RuleArena: A Benchmark for Rule-Guided Reasoning with LLMs in Real-World Scenarios(RuleArena:在现实场景中评估LLMs规则引导推理能力的基准)
[] 👀 Gaze-LLE: Gaze Target Estimation via Large-Scale Learned Encoders(Gaze-LLE:通过大规模学习编码器进行注视目标估计)
[] 🧠 JuStRank: Benchmarking LLM Judges for System Ranking(JuStRank:基准测试用于系统排名的LLM评判器)
[] 🧠 OLA-VLM: Elevating Visual Perception in Multimodal LLMs with Auxiliary Embedding Distillation(OLA-VLM:通过辅助嵌入蒸馏提升多模态大语言模型的视觉感知能力)
[] 📚 The Impact of Copyrighted Material on Large Language Models: A Norwegian Perspective(版权材料对大型语言模型的影响:挪威视角)
[] 🔗 Word Sense Linking: Disambiguating Outside the Sandbox(词义链接:超越沙盒的消歧)
[] 🌐 FreeSplatter: Pose-free Gaussian Splatting for Sparse-view 3D Reconstruction(FreeSplatter:无姿态高斯喷射用于稀疏视图三维重建)
[] 🎥 DisPose: Disentangling Pose Guidance for Controllable Human Image Animation(DisPose:解耦姿态引导的可控人体图像动画)
[] 🖼 LoRACLR: Contrastive Adaptation for Customization of Diffusion Models(LoRACLR:对比适应用于扩散模型的定制化)
[] 🧭 SAME: Learning Generic Language-Guided Visual Navigation with State-Adaptive Mixture of Experts(SAME:学习基于状态自适应混合专家的通用语言引导视觉导航)
[] 🌟 Arbitrary-steps Image Super-resolution via Diffusion Inversion(基于扩散反演的任意步图像超分辨率)
[] 📚 Shiksha: A Technical Domain focused Translation Dataset and Model for Indian Languages(Shiksha:面向印度语言的技术领域翻译数据集与模型)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟