H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

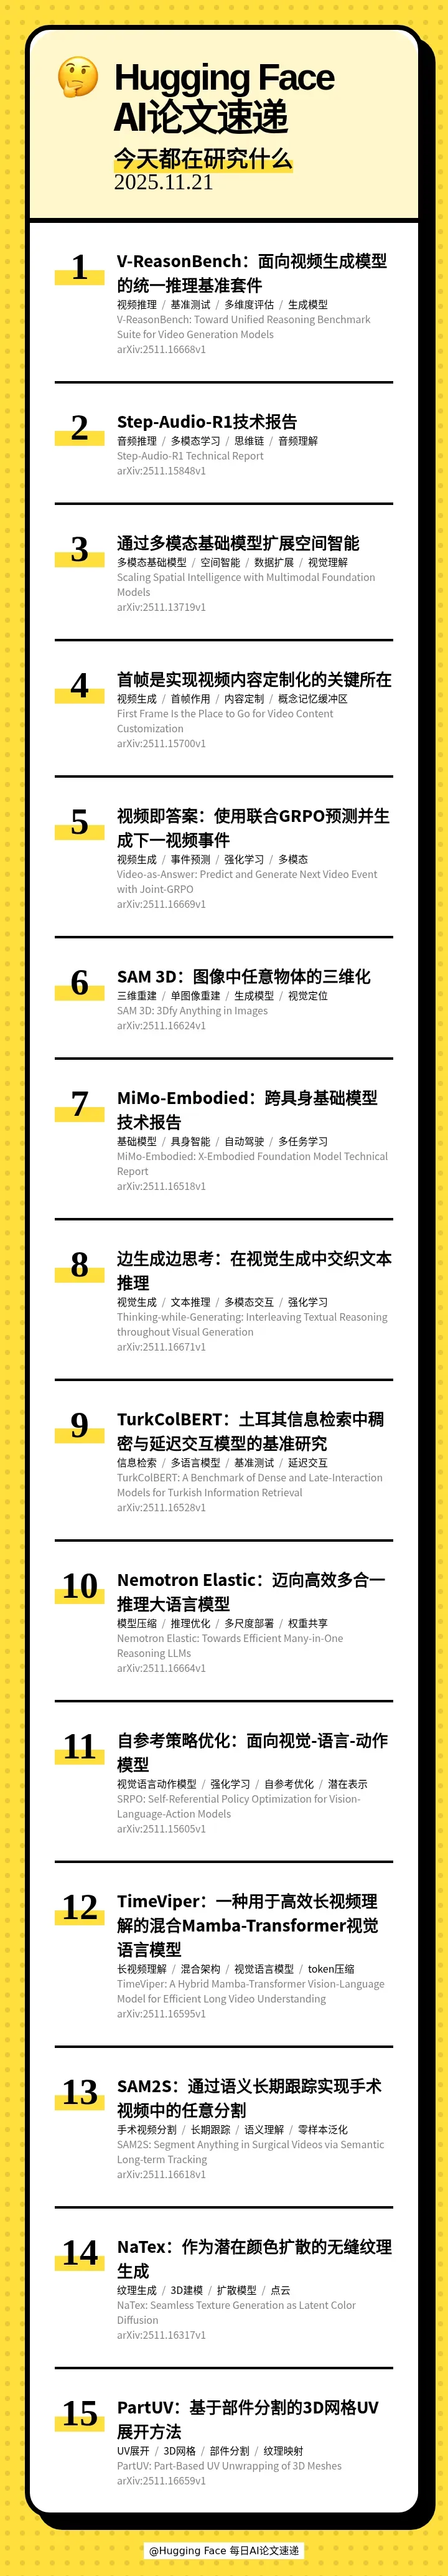
本期的 15 篇论文如下:
[] 📊 V-ReasonBench: Toward Unified Reasoning Benchmark Suite for Video Generation Models(V-ReasonBench:面向视频生成模型的统一推理基准套件)
[] 🧠 Step-Audio-R1 Technical Report(Step-Audio-R1技术报告)
[] 🧭 Scaling Spatial Intelligence with Multimodal Foundation Models(通过多模态基础模型扩展空间智能)
[] 🎬 First Frame Is the Place to Go for Video Content Customization(首帧是实现视频内容定制化的关键所在)
[] 🎬 Video-as-Answer: Predict and Generate Next Video Event with Joint-GRPO(视频即答案:使用联合GRPO预测并生成下一视频事件)
[] 🔮 SAM 3D: 3Dfy Anything in Images(SAM 3D:图像中任意物体的三维化)
[] 🚀 MiMo-Embodied: X-Embodied Foundation Model Technical Report(MiMo-Embodied:跨具身基础模型技术报告)
[] 🧠 Thinking-while-Generating: Interleaving Textual Reasoning throughout Visual Generation(边生成边思考:在视觉生成中交织文本推理)
[] 🏆 TurkColBERT: A Benchmark of Dense and Late-Interaction Models for Turkish Information Retrieval(TurkColBERT:土耳其信息检索中稠密与延迟交互模型的基准研究)
[] 🌀 Nemotron Elastic: Towards Efficient Many-in-One Reasoning LLMs(Nemotron Elastic:迈向高效多合一推理大语言模型)
[] 🚀 SRPO: Self-Referential Policy Optimization for Vision-Language-Action Models(自参考策略优化:面向视觉-语言-动作模型)
[] 🎬 TimeViper: A Hybrid Mamba-Transformer Vision-Language Model for Efficient Long Video Understanding(TimeViper:一种用于高效长视频理解的混合Mamba-Transformer视觉语言模型)
[] 🔬 SAM2S: Segment Anything in Surgical Videos via Semantic Long-term Tracking(SAM2S:通过语义长期跟踪实现手术视频中的任意分割)
[] 🎨 NaTex: Seamless Texture Generation as Latent Color Diffusion(NaTex:作为潜在颜色扩散的无缝纹理生成)
[] 📐 PartUV: Part-Based UV Unwrapping of 3D Meshes(PartUV:基于部件分割的3D网格UV展开方法)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 11 月 22 日 · 10 分钟
本期的 15 篇论文如下:
[] 📊 V-ReasonBench: Toward Unified Reasoning Benchmark Suite for Video Generation Models(V-ReasonBench:面向视频生成模型的统一推理基准套件)
[] 🧠 Step-Audio-R1 Technical Report(Step-Audio-R1技术报告)
[] 🧭 Scaling Spatial Intelligence with Multimodal Foundation Models(通过多模态基础模型扩展空间智能)
[] 🎬 First Frame Is the Place to Go for Video Content Customization(首帧是实现视频内容定制化的关键所在)
[] 🎬 Video-as-Answer: Predict and Generate Next Video Event with Joint-GRPO(视频即答案:使用联合GRPO预测并生成下一视频事件)
[] 🔮 SAM 3D: 3Dfy Anything in Images(SAM 3D:图像中任意物体的三维化)
[] 🚀 MiMo-Embodied: X-Embodied Foundation Model Technical Report(MiMo-Embodied:跨具身基础模型技术报告)
[] 🧠 Thinking-while-Generating: Interleaving Textual Reasoning throughout Visual Generation(边生成边思考:在视觉生成中交织文本推理)
[] 🏆 TurkColBERT: A Benchmark of Dense and Late-Interaction Models for Turkish Information Retrieval(TurkColBERT:土耳其信息检索中稠密与延迟交互模型的基准研究)
[] 🌀 Nemotron Elastic: Towards Efficient Many-in-One Reasoning LLMs(Nemotron Elastic:迈向高效多合一推理大语言模型)
[] 🚀 SRPO: Self-Referential Policy Optimization for Vision-Language-Action Models(自参考策略优化:面向视觉-语言-动作模型)
[] 🎬 TimeViper: A Hybrid Mamba-Transformer Vision-Language Model for Efficient Long Video Understanding(TimeViper:一种用于高效长视频理解的混合Mamba-Transformer视觉语言模型)
[] 🔬 SAM2S: Segment Anything in Surgical Videos via Semantic Long-term Tracking(SAM2S:通过语义长期跟踪实现手术视频中的任意分割)
[] 🎨 NaTex: Seamless Texture Generation as Latent Color Diffusion(NaTex:作为潜在颜色扩散的无缝纹理生成)
[] 📐 PartUV: Part-Based UV Unwrapping of 3D Meshes(PartUV:基于部件分割的3D网格UV展开方法)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟