H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

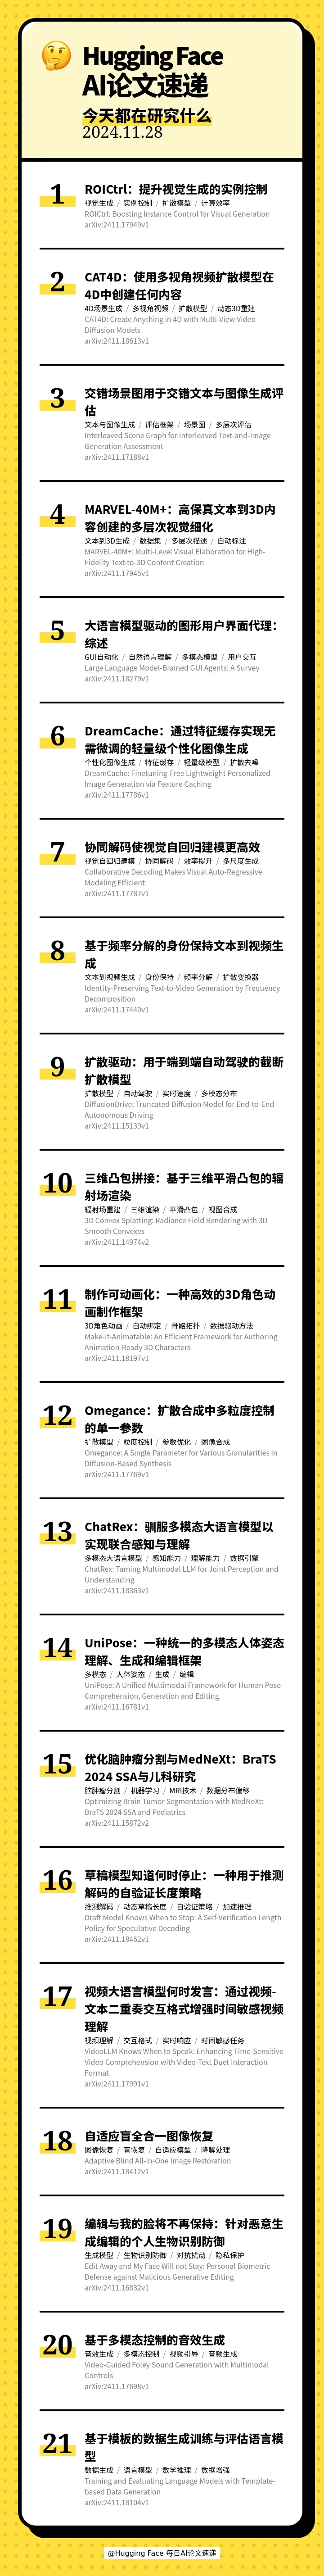
本期的 21 篇论文如下:
[] 🖼 ROICtrl: Boosting Instance Control for Visual Generation(ROICtrl:提升视觉生成的实例控制)
[] 🎥 CAT4D: Create Anything in 4D with Multi-View Video Diffusion Models(CAT4D:使用多视角视频扩散模型在4D中创建任何内容)
[] 📚 Interleaved Scene Graph for Interleaved Text-and-Image Generation Assessment(交错场景图用于交错文本与图像生成评估)
[] 🌐 MARVEL-40M+: Multi-Level Visual Elaboration for High-Fidelity Text-to-3D Content Creation(MARVEL-40M+:高保真文本到3D内容创建的多层次视觉细化)
[] 🤖 Large Language Model-Brained GUI Agents: A Survey(大语言模型驱动的图形用户界面代理:综述)
[] 🎨 DreamCache: Finetuning-Free Lightweight Personalized Image Generation via Feature Caching(DreamCache:通过特征缓存实现无需微调的轻量级个性化图像生成)
[] ⚡ Collaborative Decoding Makes Visual Auto-Regressive Modeling Efficient(协同解码使视觉自回归建模更高效)
[] 🎥 Identity-Preserving Text-to-Video Generation by Frequency Decomposition(基于频率分解的身份保持文本到视频生成)
[] 🚗 DiffusionDrive: Truncated Diffusion Model for End-to-End Autonomous Driving(扩散驱动:用于端到端自动驾驶的截断扩散模型)
[] 🔺 3D Convex Splatting: Radiance Field Rendering with 3D Smooth Convexes(三维凸包拼接:基于三维平滑凸包的辐射场渲染)
[] 🎭 Make-It-Animatable: An Efficient Framework for Authoring Animation-Ready 3D Characters(制作可动画化:一种高效的3D角色动画制作框架)
[] 🎛 Omegance: A Single Parameter for Various Granularities in Diffusion-Based Synthesis(Omegance:扩散合成中多粒度控制的单一参数)
[] 🦖 ChatRex: Taming Multimodal LLM for Joint Perception and Understanding(ChatRex:驯服多模态大语言模型以实现联合感知与理解)
[] 🧍 UniPose: A Unified Multimodal Framework for Human Pose Comprehension, Generation and Editing(UniPose:一种统一的多模态人体姿态理解、生成和编辑框架)
[] 🧠 Optimizing Brain Tumor Segmentation with MedNeXt: BraTS 2024 SSA and Pediatrics(优化脑肿瘤分割与MedNeXt:BraTS 2024 SSA与儿科研究)
[] ⏱ Draft Model Knows When to Stop: A Self-Verification Length Policy for Speculative Decoding(草稿模型知道何时停止:一种用于推测解码的自验证长度策略)
[] 🎙 VideoLLM Knows When to Speak: Enhancing Time-Sensitive Video Comprehension with Video-Text Duet Interaction Format(视频大语言模型何时发言:通过视频-文本二重奏交互格式增强时间敏感视频理解)
[] 🌟 Adaptive Blind All-in-One Image Restoration(自适应盲全合一图像恢复)
[] 🛡 Edit Away and My Face Will not Stay: Personal Biometric Defense against Malicious Generative Editing(编辑与我的脸将不再保持:针对恶意生成编辑的个人生物识别防御)
[] 🎥 Video-Guided Foley Sound Generation with Multimodal Controls(基于多模态控制的音效生成)
[] 📚 Training and Evaluating Language Models with Template-based Data Generation(基于模板的数据生成训练与评估语言模型)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2024 年 11 月 29 日 · 15 分钟
本期的 21 篇论文如下:
[] 🖼 ROICtrl: Boosting Instance Control for Visual Generation(ROICtrl:提升视觉生成的实例控制)
[] 🎥 CAT4D: Create Anything in 4D with Multi-View Video Diffusion Models(CAT4D:使用多视角视频扩散模型在4D中创建任何内容)
[] 📚 Interleaved Scene Graph for Interleaved Text-and-Image Generation Assessment(交错场景图用于交错文本与图像生成评估)
[] 🌐 MARVEL-40M+: Multi-Level Visual Elaboration for High-Fidelity Text-to-3D Content Creation(MARVEL-40M+:高保真文本到3D内容创建的多层次视觉细化)
[] 🤖 Large Language Model-Brained GUI Agents: A Survey(大语言模型驱动的图形用户界面代理:综述)
[] 🎨 DreamCache: Finetuning-Free Lightweight Personalized Image Generation via Feature Caching(DreamCache:通过特征缓存实现无需微调的轻量级个性化图像生成)
[] ⚡ Collaborative Decoding Makes Visual Auto-Regressive Modeling Efficient(协同解码使视觉自回归建模更高效)
[] 🎥 Identity-Preserving Text-to-Video Generation by Frequency Decomposition(基于频率分解的身份保持文本到视频生成)
[] 🚗 DiffusionDrive: Truncated Diffusion Model for End-to-End Autonomous Driving(扩散驱动:用于端到端自动驾驶的截断扩散模型)
[] 🔺 3D Convex Splatting: Radiance Field Rendering with 3D Smooth Convexes(三维凸包拼接:基于三维平滑凸包的辐射场渲染)
[] 🎭 Make-It-Animatable: An Efficient Framework for Authoring Animation-Ready 3D Characters(制作可动画化:一种高效的3D角色动画制作框架)
[] 🎛 Omegance: A Single Parameter for Various Granularities in Diffusion-Based Synthesis(Omegance:扩散合成中多粒度控制的单一参数)
[] 🦖 ChatRex: Taming Multimodal LLM for Joint Perception and Understanding(ChatRex:驯服多模态大语言模型以实现联合感知与理解)
[] 🧍 UniPose: A Unified Multimodal Framework for Human Pose Comprehension, Generation and Editing(UniPose:一种统一的多模态人体姿态理解、生成和编辑框架)
[] 🧠 Optimizing Brain Tumor Segmentation with MedNeXt: BraTS 2024 SSA and Pediatrics(优化脑肿瘤分割与MedNeXt:BraTS 2024 SSA与儿科研究)
[] ⏱ Draft Model Knows When to Stop: A Self-Verification Length Policy for Speculative Decoding(草稿模型知道何时停止:一种用于推测解码的自验证长度策略)
[] 🎙 VideoLLM Knows When to Speak: Enhancing Time-Sensitive Video Comprehension with Video-Text Duet Interaction Format(视频大语言模型何时发言:通过视频-文本二重奏交互格式增强时间敏感视频理解)
[] 🌟 Adaptive Blind All-in-One Image Restoration(自适应盲全合一图像恢复)
[] 🛡 Edit Away and My Face Will not Stay: Personal Biometric Defense against Malicious Generative Editing(编辑与我的脸将不再保持:针对恶意生成编辑的个人生物识别防御)
[] 🎥 Video-Guided Foley Sound Generation with Multimodal Controls(基于多模态控制的音效生成)
[] 📚 Training and Evaluating Language Models with Template-based Data Generation(基于模板的数据生成训练与评估语言模型)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟