H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 15 篇论文如下:
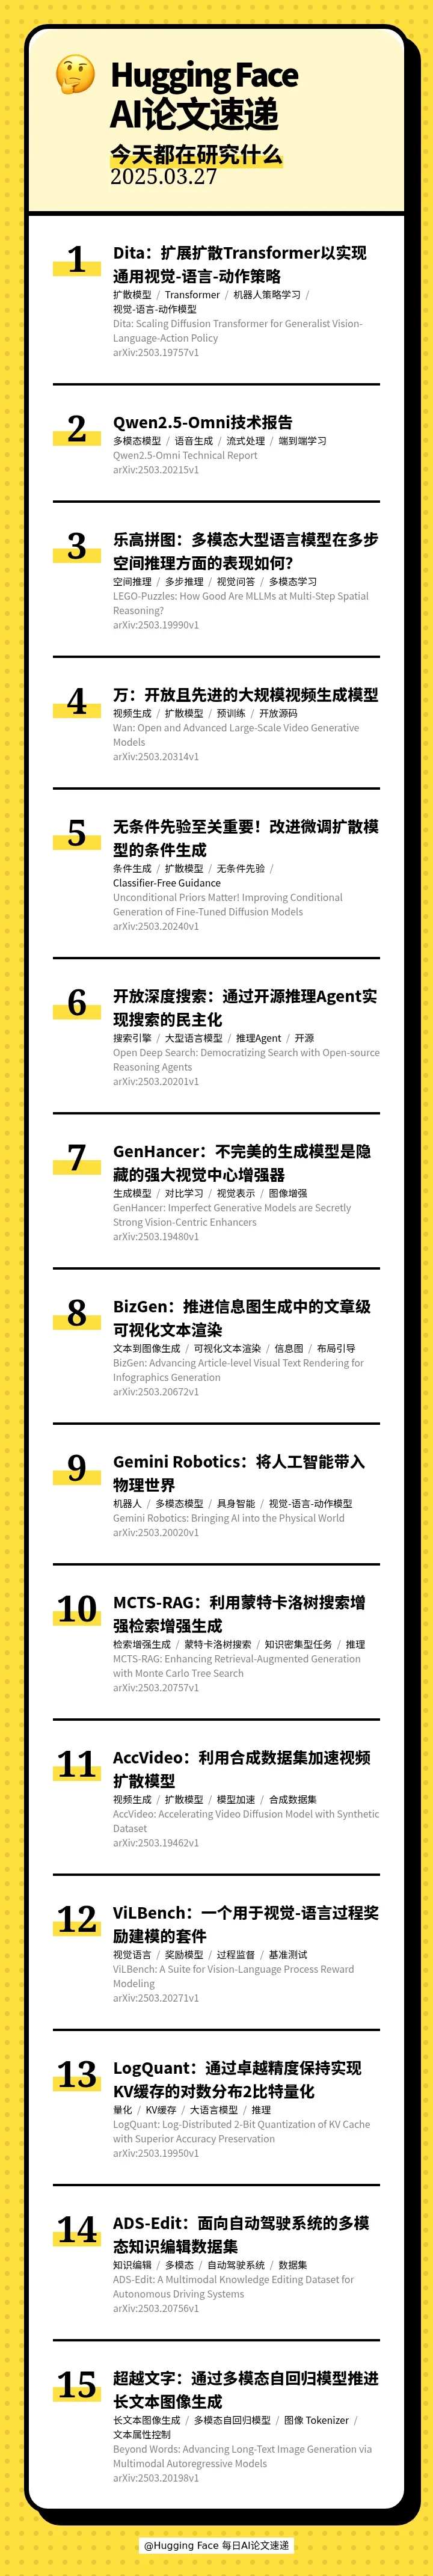
[] 🤖 Dita: Scaling Diffusion Transformer for Generalist Vision-Language-Action Policy(Dita:扩展扩散Transformer以实现通用视觉-语言-动作策略)
[] 🤖 Qwen2.5-Omni Technical Report(Qwen2.5-Omni技术报告)
[] 🧩 LEGO-Puzzles: How Good Are MLLMs at Multi-Step Spatial Reasoning?(乐高拼图:多模态大型语言模型在多步空间推理方面的表现如何?)
[] 🎬 Wan: Open and Advanced Large-Scale Video Generative Models(万:开放且先进的大规模视频生成模型)
[] 💡 Unconditional Priors Matter! Improving Conditional Generation of Fine-Tuned Diffusion Models(无条件先验至关重要!改进微调扩散模型的条件生成)
[] 🔍 Open Deep Search: Democratizing Search with Open-source Reasoning Agents(开放深度搜索:通过开源推理Agent实现搜索的民主化)
[] 🖼 GenHancer: Imperfect Generative Models are Secretly Strong Vision-Centric Enhancers(GenHancer:不完美的生成模型是隐藏的强大视觉中心增强器)
[] 📊 BizGen: Advancing Article-level Visual Text Rendering for Infographics Generation(BizGen:推进信息图生成中的文章级可视化文本渲染)
[] 🤖 Gemini Robotics: Bringing AI into the Physical World(Gemini Robotics:将人工智能带入物理世界)
[] 🧠 MCTS-RAG: Enhancing Retrieval-Augmented Generation with Monte Carlo Tree Search(MCTS-RAG:利用蒙特卡洛树搜索增强检索增强生成)
[] 🚀 AccVideo: Accelerating Video Diffusion Model with Synthetic Dataset(AccVideo:利用合成数据集加速视频扩散模型)
[] 🖼 ViLBench: A Suite for Vision-Language Process Reward Modeling(ViLBench:一个用于视觉-语言过程奖励建模的套件)
[] 💾 LogQuant: Log-Distributed 2-Bit Quantization of KV Cache with Superior Accuracy Preservation(LogQuant:通过卓越精度保持实现KV缓存的对数分布2比特量化)
[] 🚗 ADS-Edit: A Multimodal Knowledge Editing Dataset for Autonomous Driving Systems(ADS-Edit:面向自动驾驶系统的多模态知识编辑数据集)
[] 🖼 Beyond Words: Advancing Long-Text Image Generation via Multimodal Autoregressive Models(超越文字:通过多模态自回归模型推进长文本图像生成)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 3 月 28 日 · 11 分钟
本期的 15 篇论文如下:
[] 🤖 Dita: Scaling Diffusion Transformer for Generalist Vision-Language-Action Policy(Dita:扩展扩散Transformer以实现通用视觉-语言-动作策略)
[] 🤖 Qwen2.5-Omni Technical Report(Qwen2.5-Omni技术报告)
[] 🧩 LEGO-Puzzles: How Good Are MLLMs at Multi-Step Spatial Reasoning?(乐高拼图:多模态大型语言模型在多步空间推理方面的表现如何?)
[] 🎬 Wan: Open and Advanced Large-Scale Video Generative Models(万:开放且先进的大规模视频生成模型)
[] 💡 Unconditional Priors Matter! Improving Conditional Generation of Fine-Tuned Diffusion Models(无条件先验至关重要!改进微调扩散模型的条件生成)
[] 🔍 Open Deep Search: Democratizing Search with Open-source Reasoning Agents(开放深度搜索:通过开源推理Agent实现搜索的民主化)
[] 🖼 GenHancer: Imperfect Generative Models are Secretly Strong Vision-Centric Enhancers(GenHancer:不完美的生成模型是隐藏的强大视觉中心增强器)
[] 📊 BizGen: Advancing Article-level Visual Text Rendering for Infographics Generation(BizGen:推进信息图生成中的文章级可视化文本渲染)
[] 🤖 Gemini Robotics: Bringing AI into the Physical World(Gemini Robotics:将人工智能带入物理世界)
[] 🧠 MCTS-RAG: Enhancing Retrieval-Augmented Generation with Monte Carlo Tree Search(MCTS-RAG:利用蒙特卡洛树搜索增强检索增强生成)
[] 🚀 AccVideo: Accelerating Video Diffusion Model with Synthetic Dataset(AccVideo:利用合成数据集加速视频扩散模型)
[] 🖼 ViLBench: A Suite for Vision-Language Process Reward Modeling(ViLBench:一个用于视觉-语言过程奖励建模的套件)
[] 💾 LogQuant: Log-Distributed 2-Bit Quantization of KV Cache with Superior Accuracy Preservation(LogQuant:通过卓越精度保持实现KV缓存的对数分布2比特量化)
[] 🚗 ADS-Edit: A Multimodal Knowledge Editing Dataset for Autonomous Driving Systems(ADS-Edit:面向自动驾驶系统的多模态知识编辑数据集)
[] 🖼 Beyond Words: Advancing Long-Text Image Generation via Multimodal Autoregressive Models(超越文字:通过多模态自回归模型推进长文本图像生成)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟