H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

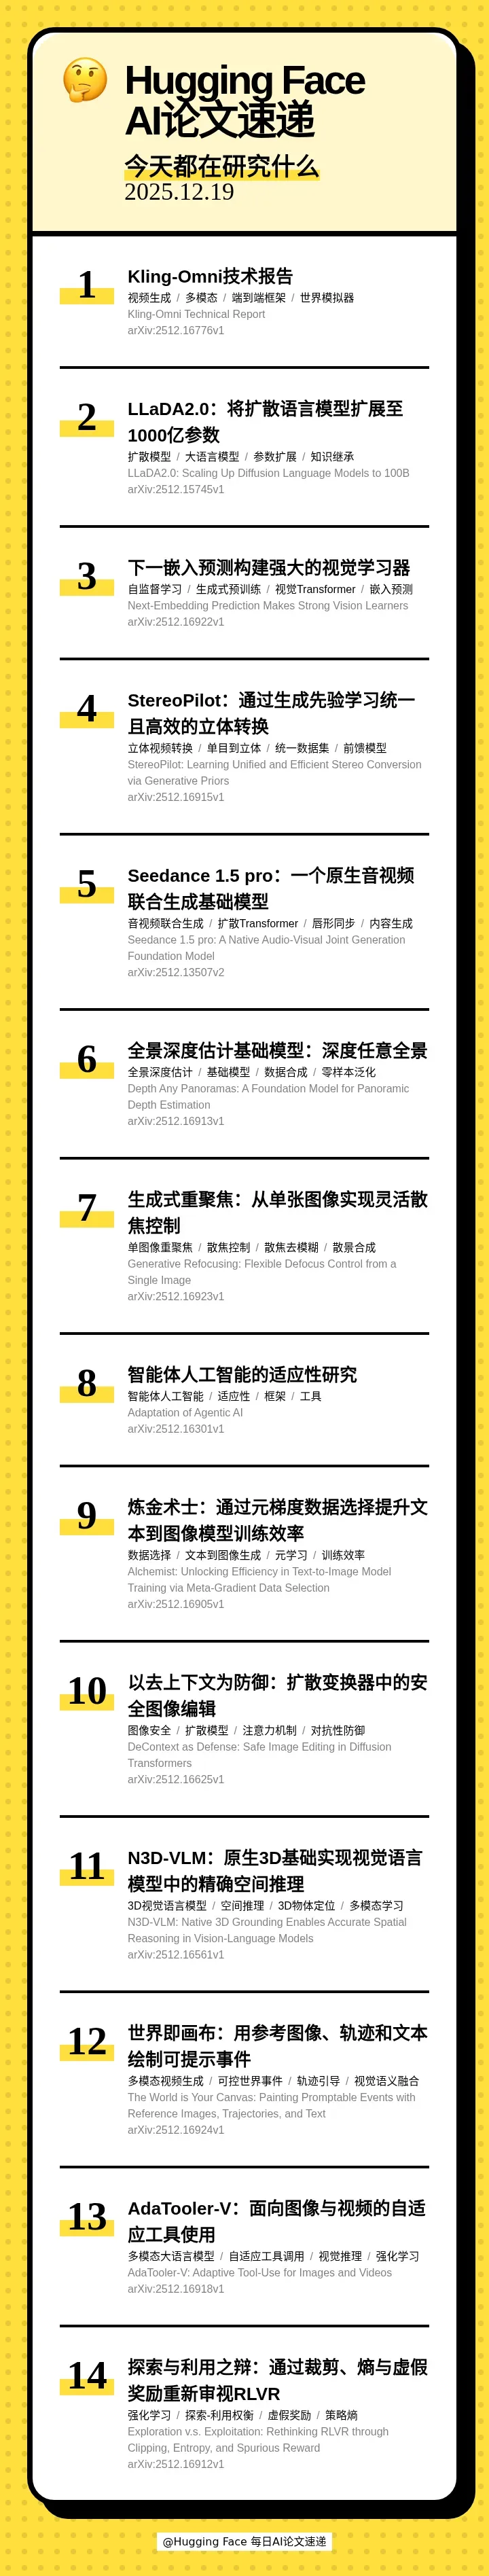
本期的 14 篇论文如下:
[] 🎬 Kling-Omni Technical Report(Kling-Omni技术报告)
[] 🚀 LLaDA2.0: Scaling Up Diffusion Language Models to 100B(LLaDA2.0:将扩散语言模型扩展至1000亿参数)
[] 🔮 Next-Embedding Prediction Makes Strong Vision Learners(下一嵌入预测构建强大的视觉学习器)
[] 👓 StereoPilot: Learning Unified and Efficient Stereo Conversion via Generative Priors(StereoPilot:通过生成先验学习统一且高效的立体转换)
[] 🎬 Seedance 1.5 pro: A Native Audio-Visual Joint Generation Foundation Model(Seedance 1.5 pro:一个原生音视频联合生成基础模型)
[] 🔭 Depth Any Panoramas: A Foundation Model for Panoramic Depth Estimation(全景深度估计基础模型:深度任意全景)
[] 📸 Generative Refocusing: Flexible Defocus Control from a Single Image(生成式重聚焦:从单张图像实现灵活散焦控制)
[] 🤖 Adaptation of Agentic AI(智能体人工智能的适应性研究)
[] ⚗ Alchemist: Unlocking Efficiency in Text-to-Image Model Training via Meta-Gradient Data Selection(炼金术士:通过元梯度数据选择提升文本到图像模型训练效率)
[] 🛡 DeContext as Defense: Safe Image Editing in Diffusion Transformers(以去上下文为防御:扩散变换器中的安全图像编辑)
[] 🧭 N3D-VLM: Native 3D Grounding Enables Accurate Spatial Reasoning in Vision-Language Models(N3D-VLM:原生3D基础实现视觉语言模型中的精确空间推理)
[] 🎨 The World is Your Canvas: Painting Promptable Events with Reference Images, Trajectories, and Text(世界即画布:用参考图像、轨迹和文本绘制可提示事件)
[] 🔧 AdaTooler-V: Adaptive Tool-Use for Images and Videos(AdaTooler-V:面向图像与视频的自适应工具使用)
[] 🤔 Exploration v.s. Exploitation: Rethinking RLVR through Clipping, Entropy, and Spurious Reward(探索与利用之辩:通过裁剪、熵与虚假奖励重新审视RLVR)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 12 月 20 日 · 10 分钟
本期的 14 篇论文如下:
[] 🎬 Kling-Omni Technical Report(Kling-Omni技术报告)
[] 🚀 LLaDA2.0: Scaling Up Diffusion Language Models to 100B(LLaDA2.0:将扩散语言模型扩展至1000亿参数)
[] 🔮 Next-Embedding Prediction Makes Strong Vision Learners(下一嵌入预测构建强大的视觉学习器)
[] 👓 StereoPilot: Learning Unified and Efficient Stereo Conversion via Generative Priors(StereoPilot:通过生成先验学习统一且高效的立体转换)
[] 🎬 Seedance 1.5 pro: A Native Audio-Visual Joint Generation Foundation Model(Seedance 1.5 pro:一个原生音视频联合生成基础模型)
[] 🔭 Depth Any Panoramas: A Foundation Model for Panoramic Depth Estimation(全景深度估计基础模型:深度任意全景)
[] 📸 Generative Refocusing: Flexible Defocus Control from a Single Image(生成式重聚焦:从单张图像实现灵活散焦控制)
[] 🤖 Adaptation of Agentic AI(智能体人工智能的适应性研究)
[] ⚗ Alchemist: Unlocking Efficiency in Text-to-Image Model Training via Meta-Gradient Data Selection(炼金术士:通过元梯度数据选择提升文本到图像模型训练效率)
[] 🛡 DeContext as Defense: Safe Image Editing in Diffusion Transformers(以去上下文为防御:扩散变换器中的安全图像编辑)
[] 🧭 N3D-VLM: Native 3D Grounding Enables Accurate Spatial Reasoning in Vision-Language Models(N3D-VLM:原生3D基础实现视觉语言模型中的精确空间推理)
[] 🎨 The World is Your Canvas: Painting Promptable Events with Reference Images, Trajectories, and Text(世界即画布:用参考图像、轨迹和文本绘制可提示事件)
[] 🔧 AdaTooler-V: Adaptive Tool-Use for Images and Videos(AdaTooler-V:面向图像与视频的自适应工具使用)
[] 🤔 Exploration v.s. Exploitation: Rethinking RLVR through Clipping, Entropy, and Spurious Reward(探索与利用之辩:通过裁剪、熵与虚假奖励重新审视RLVR)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟