H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 15 篇论文如下:
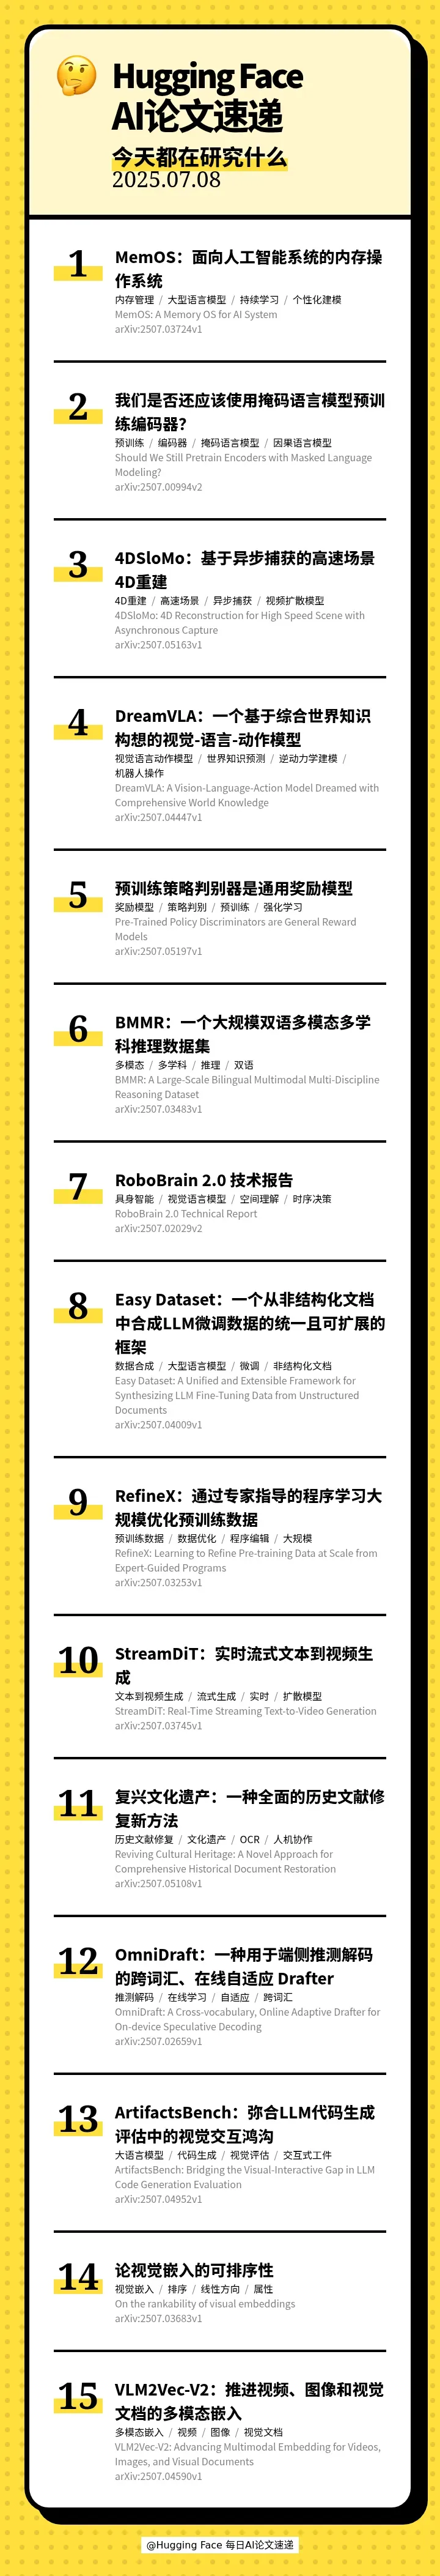
[] 🧠 MemOS: A Memory OS for AI System(MemOS:面向人工智能系统的内存操作系统)
[] 🤔 Should We Still Pretrain Encoders with Masked Language Modeling?(我们是否还应该使用掩码语言模型预训练编码器?)
[] 🎥 4DSloMo: 4D Reconstruction for High Speed Scene with Asynchronous Capture(4DSloMo:基于异步捕获的高速场景4D重建)
[] 🤖 DreamVLA: A Vision-Language-Action Model Dreamed with Comprehensive World Knowledge(DreamVLA:一个基于综合世界知识构想的视觉-语言-动作模型)
[] 🤖 Pre-Trained Policy Discriminators are General Reward Models(预训练策略判别器是通用奖励模型)
[] 🧠 BMMR: A Large-Scale Bilingual Multimodal Multi-Discipline Reasoning Dataset(BMMR:一个大规模双语多模态多学科推理数据集)
[] 🤖 RoboBrain 2.0 Technical Report(RoboBrain 2.0 技术报告)
[] 🧩 Easy Dataset: A Unified and Extensible Framework for Synthesizing LLM Fine-Tuning Data from Unstructured Documents(Easy Dataset:一个从非结构化文档中合成LLM微调数据的统一且可扩展的框架)
[] ✨ RefineX: Learning to Refine Pre-training Data at Scale from Expert-Guided Programs(RefineX:通过专家指导的程序学习大规模优化预训练数据)
[] 🎬 StreamDiT: Real-Time Streaming Text-to-Video Generation(StreamDiT:实时流式文本到视频生成)
[] 📜 Reviving Cultural Heritage: A Novel Approach for Comprehensive Historical Document Restoration(复兴文化遗产:一种全面的历史文献修复新方法)
[] 💡 OmniDraft: A Cross-vocabulary, Online Adaptive Drafter for On-device Speculative Decoding(OmniDraft:一种用于端侧推测解码的跨词汇、在线自适应 Drafter)
[] 🎨 ArtifactsBench: Bridging the Visual-Interactive Gap in LLM Code Generation Evaluation(ArtifactsBench:弥合LLM代码生成评估中的视觉交互鸿沟)
[] 📊 On the rankability of visual embeddings(论视觉嵌入的可排序性)
[] 🖼 VLM2Vec-V2: Advancing Multimodal Embedding for Videos, Images, and Visual Documents(VLM2Vec-V2:推进视频、图像和视觉文档的多模态嵌入)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 7 月 9 日 · 11 分钟
本期的 15 篇论文如下:
[] 🧠 MemOS: A Memory OS for AI System(MemOS:面向人工智能系统的内存操作系统)
[] 🤔 Should We Still Pretrain Encoders with Masked Language Modeling?(我们是否还应该使用掩码语言模型预训练编码器?)
[] 🎥 4DSloMo: 4D Reconstruction for High Speed Scene with Asynchronous Capture(4DSloMo:基于异步捕获的高速场景4D重建)
[] 🤖 DreamVLA: A Vision-Language-Action Model Dreamed with Comprehensive World Knowledge(DreamVLA:一个基于综合世界知识构想的视觉-语言-动作模型)
[] 🤖 Pre-Trained Policy Discriminators are General Reward Models(预训练策略判别器是通用奖励模型)
[] 🧠 BMMR: A Large-Scale Bilingual Multimodal Multi-Discipline Reasoning Dataset(BMMR:一个大规模双语多模态多学科推理数据集)
[] 🤖 RoboBrain 2.0 Technical Report(RoboBrain 2.0 技术报告)
[] 🧩 Easy Dataset: A Unified and Extensible Framework for Synthesizing LLM Fine-Tuning Data from Unstructured Documents(Easy Dataset:一个从非结构化文档中合成LLM微调数据的统一且可扩展的框架)
[] ✨ RefineX: Learning to Refine Pre-training Data at Scale from Expert-Guided Programs(RefineX:通过专家指导的程序学习大规模优化预训练数据)
[] 🎬 StreamDiT: Real-Time Streaming Text-to-Video Generation(StreamDiT:实时流式文本到视频生成)
[] 📜 Reviving Cultural Heritage: A Novel Approach for Comprehensive Historical Document Restoration(复兴文化遗产:一种全面的历史文献修复新方法)
[] 💡 OmniDraft: A Cross-vocabulary, Online Adaptive Drafter for On-device Speculative Decoding(OmniDraft:一种用于端侧推测解码的跨词汇、在线自适应 Drafter)
[] 🎨 ArtifactsBench: Bridging the Visual-Interactive Gap in LLM Code Generation Evaluation(ArtifactsBench:弥合LLM代码生成评估中的视觉交互鸿沟)
[] 📊 On the rankability of visual embeddings(论视觉嵌入的可排序性)
[] 🖼 VLM2Vec-V2: Advancing Multimodal Embedding for Videos, Images, and Visual Documents(VLM2Vec-V2:推进视频、图像和视觉文档的多模态嵌入)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟