H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

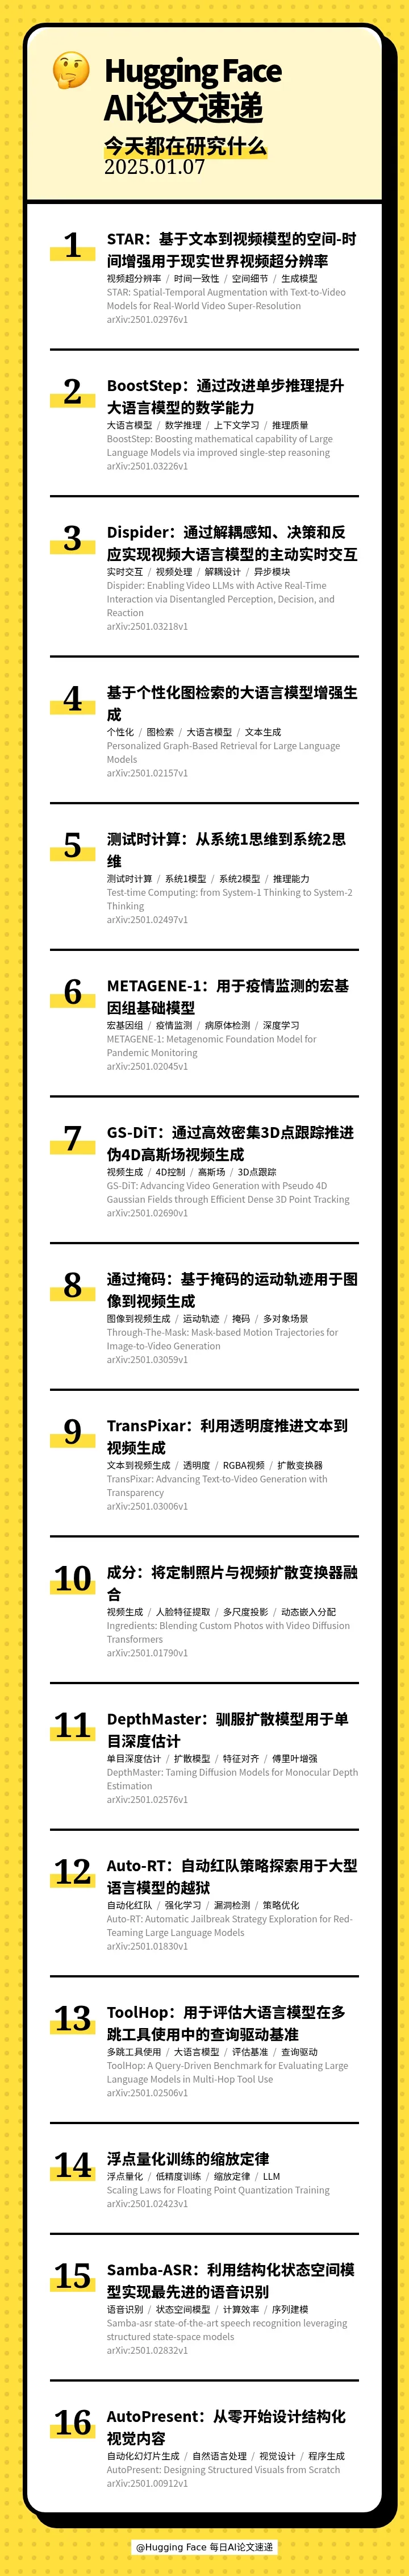
本期的 16 篇论文如下:
[] 🎥 STAR: Spatial-Temporal Augmentation with Text-to-Video Models for Real-World Video Super-Resolution(STAR:基于文本到视频模型的空间-时间增强用于现实世界视频超分辨率)
[] 🧮 BoostStep: Boosting mathematical capability of Large Language Models via improved single-step reasoning(BoostStep:通过改进单步推理提升大语言模型的数学能力)
[] 🤖 Dispider: Enabling Video LLMs with Active Real-Time Interaction via Disentangled Perception, Decision, and Reaction(Dispider:通过解耦感知、决策和反应实现视频大语言模型的主动实时交互)
[] 🧠 Personalized Graph-Based Retrieval for Large Language Models(基于个性化图检索的大语言模型增强生成)
[] 🧠 Test-time Computing: from System-1 Thinking to System-2 Thinking(测试时计算:从系统1思维到系统2思维)
[] 🦠 METAGENE-1: Metagenomic Foundation Model for Pandemic Monitoring(METAGENE-1:用于疫情监测的宏基因组基础模型)
[] 🎥 GS-DiT: Advancing Video Generation with Pseudo 4D Gaussian Fields through Efficient Dense 3D Point Tracking(GS-DiT:通过高效密集3D点跟踪推进伪4D高斯场视频生成)
[] 🎥 Through-The-Mask: Mask-based Motion Trajectories for Image-to-Video Generation(通过掩码:基于掩码的运动轨迹用于图像到视频生成)
[] 🎥 TransPixar: Advancing Text-to-Video Generation with Transparency(TransPixar:利用透明度推进文本到视频生成)
[] 🎥 Ingredients: Blending Custom Photos with Video Diffusion Transformers(成分:将定制照片与视频扩散变换器融合)
[] 🔍 DepthMaster: Taming Diffusion Models for Monocular Depth Estimation(DepthMaster:驯服扩散模型用于单目深度估计)
[] 🛡 Auto-RT: Automatic Jailbreak Strategy Exploration for Red-Teaming Large Language Models(Auto-RT:自动红队策略探索用于大型语言模型的越狱)
[] 🔍 ToolHop: A Query-Driven Benchmark for Evaluating Large Language Models in Multi-Hop Tool Use(ToolHop:用于评估大语言模型在多跳工具使用中的查询驱动基准)
[] 🔍 Scaling Laws for Floating Point Quantization Training(浮点量化训练的缩放定律)
[] 🎤 Samba-asr state-of-the-art speech recognition leveraging structured state-space models(Samba-ASR:利用结构化状态空间模型实现最先进的语音识别)
[] 🎨 AutoPresent: Designing Structured Visuals from Scratch(AutoPresent:从零开始设计结构化视觉内容)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 1 月 8 日 · 11 分钟
本期的 16 篇论文如下:
[] 🎥 STAR: Spatial-Temporal Augmentation with Text-to-Video Models for Real-World Video Super-Resolution(STAR:基于文本到视频模型的空间-时间增强用于现实世界视频超分辨率)
[] 🧮 BoostStep: Boosting mathematical capability of Large Language Models via improved single-step reasoning(BoostStep:通过改进单步推理提升大语言模型的数学能力)
[] 🤖 Dispider: Enabling Video LLMs with Active Real-Time Interaction via Disentangled Perception, Decision, and Reaction(Dispider:通过解耦感知、决策和反应实现视频大语言模型的主动实时交互)
[] 🧠 Personalized Graph-Based Retrieval for Large Language Models(基于个性化图检索的大语言模型增强生成)
[] 🧠 Test-time Computing: from System-1 Thinking to System-2 Thinking(测试时计算:从系统1思维到系统2思维)
[] 🦠 METAGENE-1: Metagenomic Foundation Model for Pandemic Monitoring(METAGENE-1:用于疫情监测的宏基因组基础模型)
[] 🎥 GS-DiT: Advancing Video Generation with Pseudo 4D Gaussian Fields through Efficient Dense 3D Point Tracking(GS-DiT:通过高效密集3D点跟踪推进伪4D高斯场视频生成)
[] 🎥 Through-The-Mask: Mask-based Motion Trajectories for Image-to-Video Generation(通过掩码:基于掩码的运动轨迹用于图像到视频生成)
[] 🎥 TransPixar: Advancing Text-to-Video Generation with Transparency(TransPixar:利用透明度推进文本到视频生成)
[] 🎥 Ingredients: Blending Custom Photos with Video Diffusion Transformers(成分:将定制照片与视频扩散变换器融合)
[] 🔍 DepthMaster: Taming Diffusion Models for Monocular Depth Estimation(DepthMaster:驯服扩散模型用于单目深度估计)
[] 🛡 Auto-RT: Automatic Jailbreak Strategy Exploration for Red-Teaming Large Language Models(Auto-RT:自动红队策略探索用于大型语言模型的越狱)
[] 🔍 ToolHop: A Query-Driven Benchmark for Evaluating Large Language Models in Multi-Hop Tool Use(ToolHop:用于评估大语言模型在多跳工具使用中的查询驱动基准)
[] 🔍 Scaling Laws for Floating Point Quantization Training(浮点量化训练的缩放定律)
[] 🎤 Samba-asr state-of-the-art speech recognition leveraging structured state-space models(Samba-ASR:利用结构化状态空间模型实现最先进的语音识别)
[] 🎨 AutoPresent: Designing Structured Visuals from Scratch(AutoPresent:从零开始设计结构化视觉内容)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟