朝
11 月 1 日 · 53 分钟
聊点稍微硬核一点的,填个之前的坑,面向非码农非AI从业者的AI模型入门。“浅”谈GPT背后模型的真实,你将听到主播尽力用大白话解释的如下内容:
无公式无复杂数学,可放心食用。同时主播水平有限,为了尽量让意思好理解可能有些错误,若有纰漏,烦请指正,提前抱歉!
主播:松阴
节目开始前,请大家加入听友群(加群方法见播客介绍页),以及帮忙多多转发!
“免责声明”
GPT到底指的是什么?
AI就是用数值化的方法对世界做参数估计
为什么是神经网络?
从one-hot encoding开始,把文字输入变成数值向量
模型输出和如何训练(损失函数和优化模型)
更好的输入:词向量 word embedding (word2vec, glove, …)
梯度下降、梯度爆炸/消失
生成式、语言模型、seq2seq
RNN 循环神经网络
Attention 注意力机制
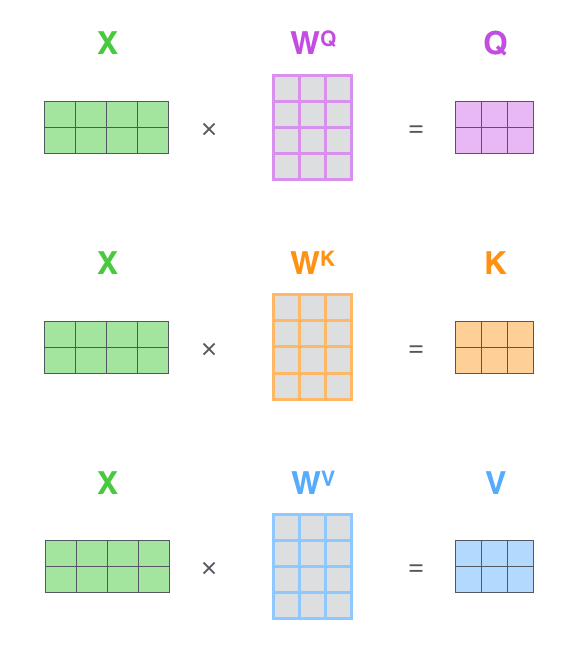
query, key, value 详解attention机制
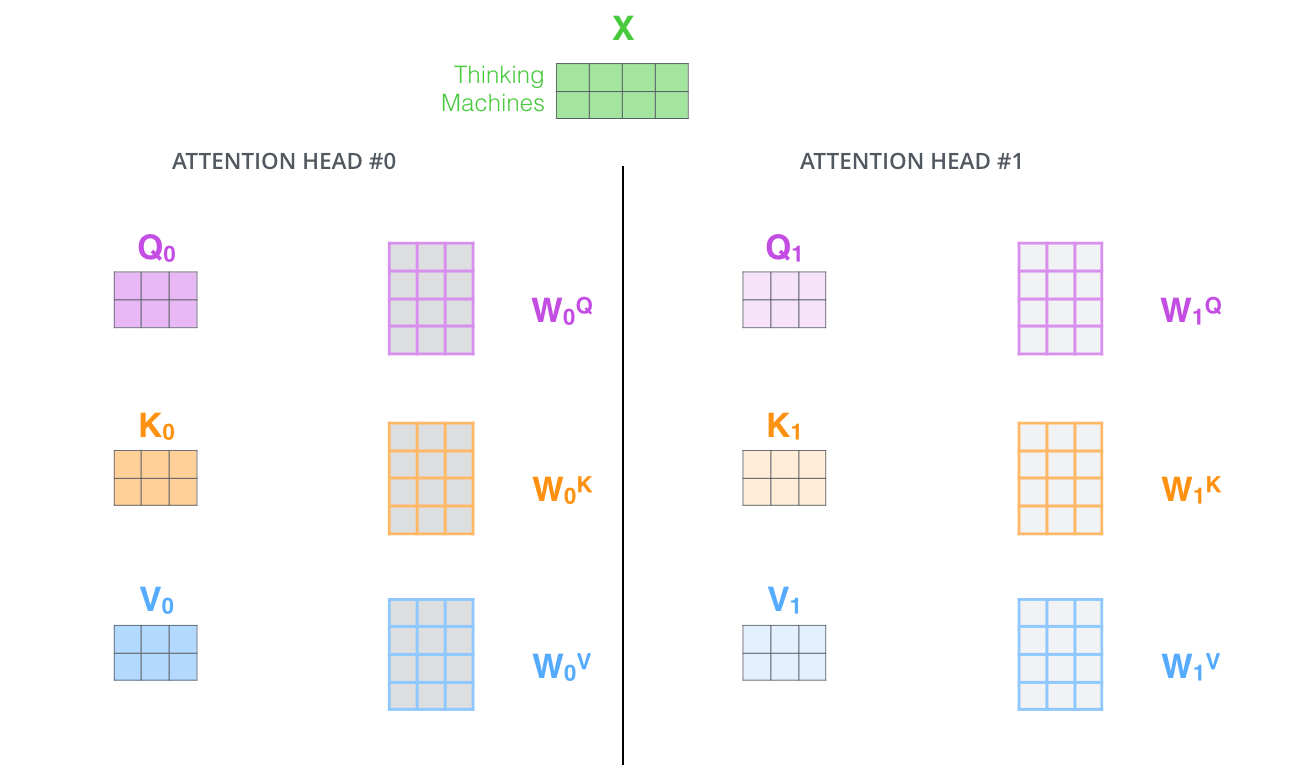
multihead 多头注意力
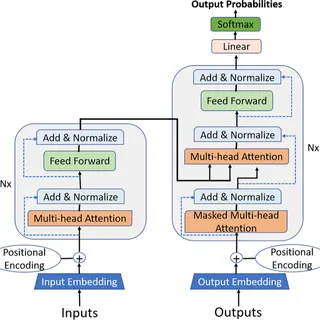
attention到Transformer
positional encoding 位置编码
训练解码器decoder需要masked attention
最终decoder生成结果需要结合encoder输出和decoder本身attention
延展资料
Transformer框架
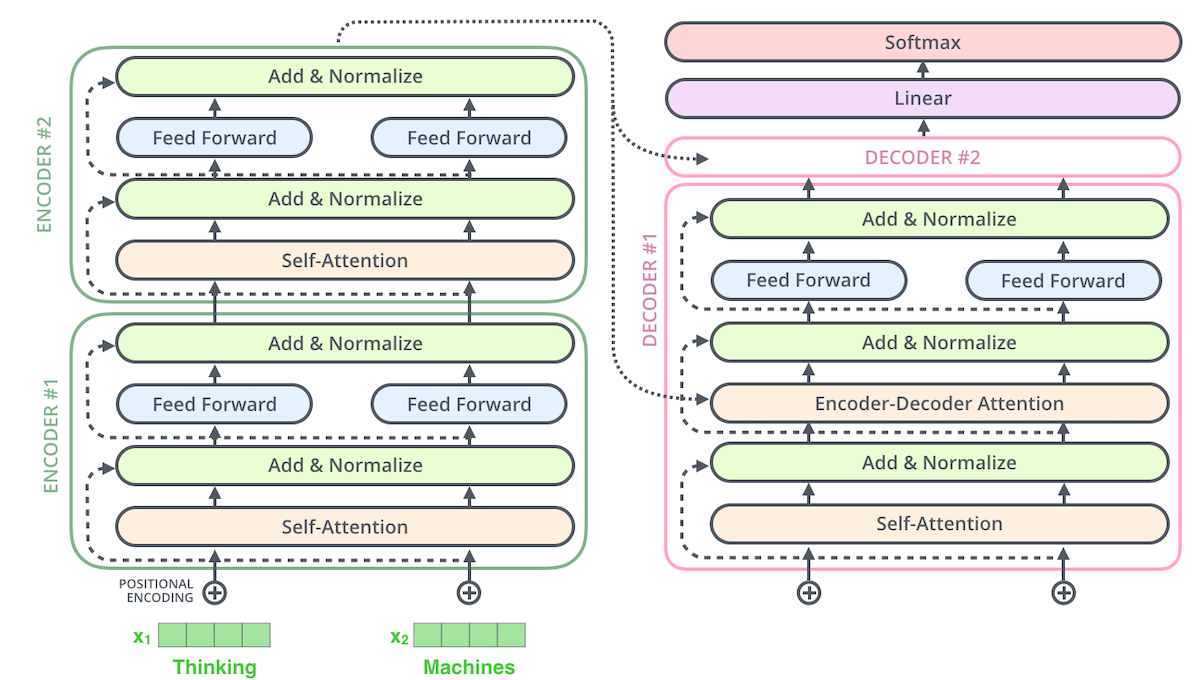
attention里的query/key/value
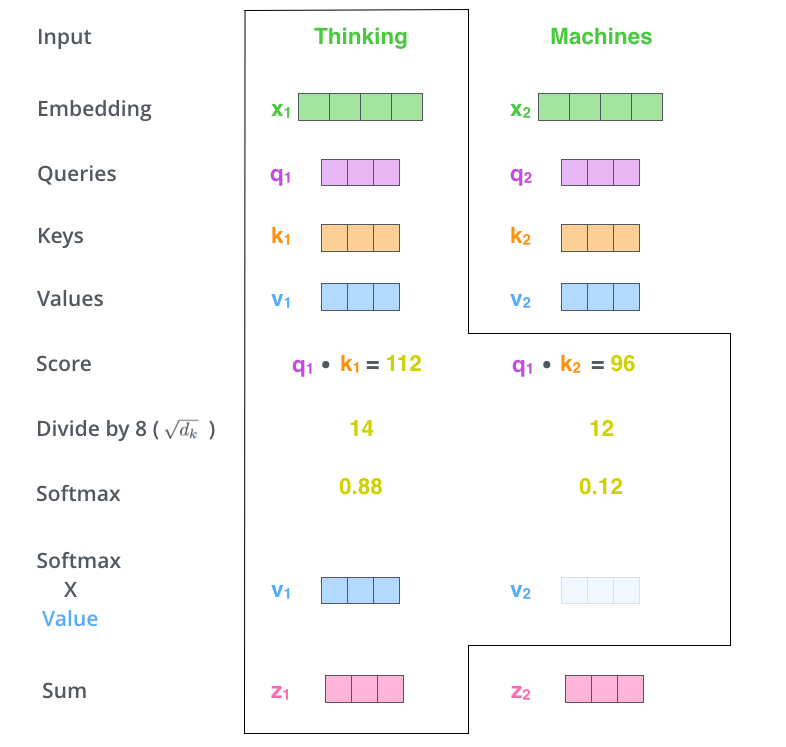
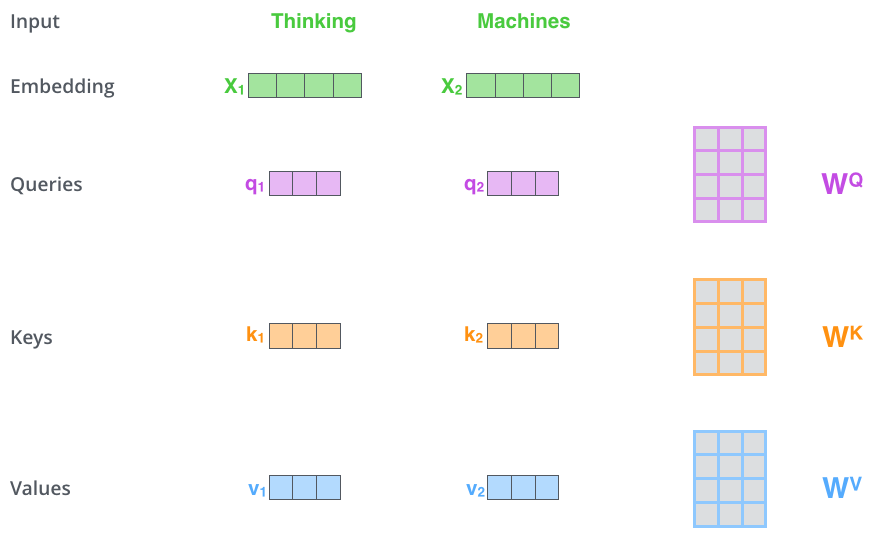
多头注意力
带你可视化了解seq2seq https://jalammar.github.io/visualizing-neural-machine-translation-mechanics-of-seq2seq-models-with-attention/
带你可视化了解attention和 transformer https://jalammar.github.io/illustrated-transformer/
PyTorch的Transformer代码教程 https://nlp.seas.harvard.edu/annotated-transformer/
attention is all you need https://arxiv.org/abs/1706.03762
说明里标出的时间点,点一下跳过去
11 月 1 日 · 53 分钟
ep149 TOKEN2049 刷屏这周,聊聊币圈十几年的骗子们
10 月 11 日 · 55 分钟
9 月 13 日 · 55 分钟
9 月 5 日 · 1 小时 34 分
朝十晚久 · 2024 年 5 月 6 日 · 46 分钟
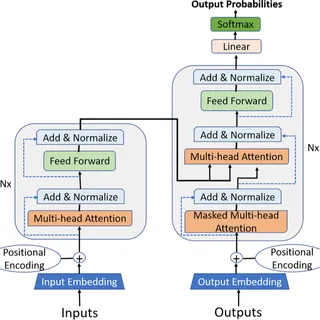
聊点稍微硬核一点的,填个之前的坑,面向非码农非AI从业者的AI模型入门。“浅”谈GPT背后模型的真实,你将听到主播尽力用大白话解释的如下内容:
无公式无复杂数学,可放心食用。同时主播水平有限,为了尽量让意思好理解可能有些错误,若有纰漏,烦请指正,提前抱歉!
主播:松阴
节目开始前,请大家加入听友群(加群方法见播客介绍页),以及帮忙多多转发!
“免责声明”
GPT到底指的是什么?
AI就是用数值化的方法对世界做参数估计
为什么是神经网络?
从one-hot encoding开始,把文字输入变成数值向量
模型输出和如何训练(损失函数和优化模型)
更好的输入:词向量 word embedding (word2vec, glove, …)
梯度下降、梯度爆炸/消失
生成式、语言模型、seq2seq
RNN 循环神经网络
Attention 注意力机制
query, key, value 详解attention机制
multihead 多头注意力
attention到Transformer
positional encoding 位置编码
训练解码器decoder需要masked attention
最终decoder生成结果需要结合encoder输出和decoder本身attention
延展资料
Transformer框架
attention里的query/key/value
多头注意力
带你可视化了解seq2seq https://jalammar.github.io/visualizing-neural-machine-translation-mechanics-of-seq2seq-models-with-attention/
带你可视化了解attention和 transformer https://jalammar.github.io/illustrated-transformer/
PyTorch的Transformer代码教程 https://nlp.seas.harvard.edu/annotated-transformer/
attention is all you need https://arxiv.org/abs/1706.03762
说明里标出的时间点,点一下跳过去
https://feed.xyzfm.space/jwdf9qdymp4j复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →