朝
11 月 1 日 · 53 分钟
DeepSeek已经炸了,已经破圈了。本期节目,我们尝试挑战一下用大白话讲述一下DeepSeek模型背后的真实。DeepSeek V3 进化 DeepSeek R1-Zero 进化 DeepSeek R1 ! 幻方到底做了哪些技术创新和奇技淫巧,让DeepSeek突然爆发成为全球顶流?所谓的“多快好省”体现在具体什么地方?
如果你不想再人云亦云地复读DeepSeek模型花钱少,那么听一听本期节目包收获的。
主播:松阴
节目开始前,请大家加入听友群(加群方法见播客介绍页),以及帮忙多多转发!
当我们谈论DeepSeek,我们到底在谈论什么模型?
DeepSeek的训练成本500万美元?!
美国业界在V3刚出的时候就注意到了
MoE 混合专家模型
门控网络:混合专家模型里的“分检”
多头潜在注意力 MLA
FP8的大模型实现
DeepSeek到底有1万张A100显卡吗?
R1-Zero的Zero来自于Alpha-Zero
强化学习 vs 监督学习
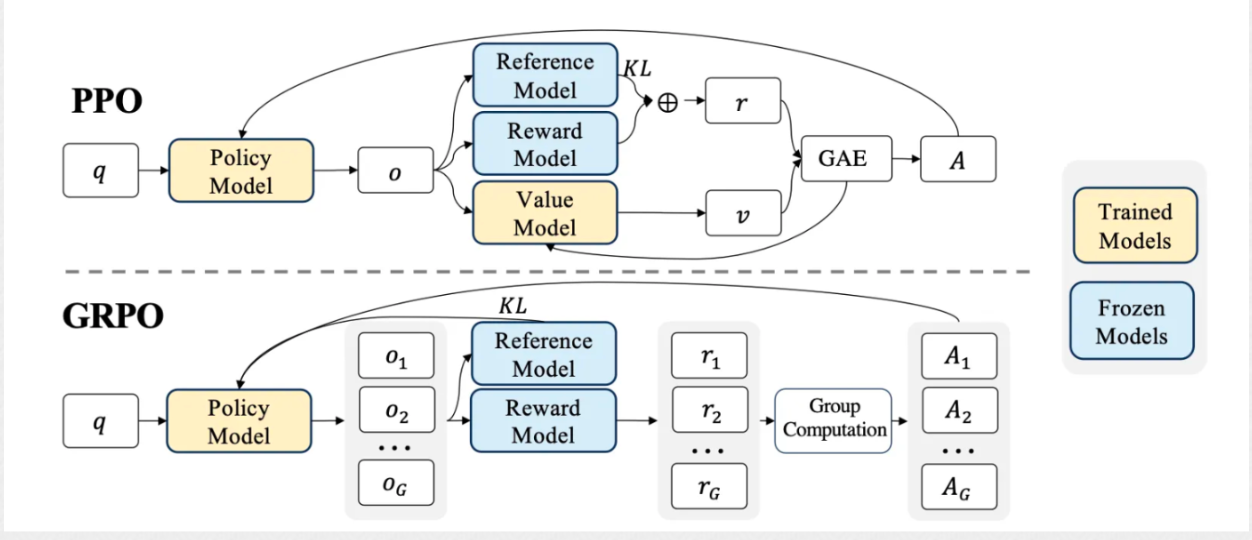
GRPO(Group Robust Preference Optimization ) vs PPO(Proximal Policy Optimization)
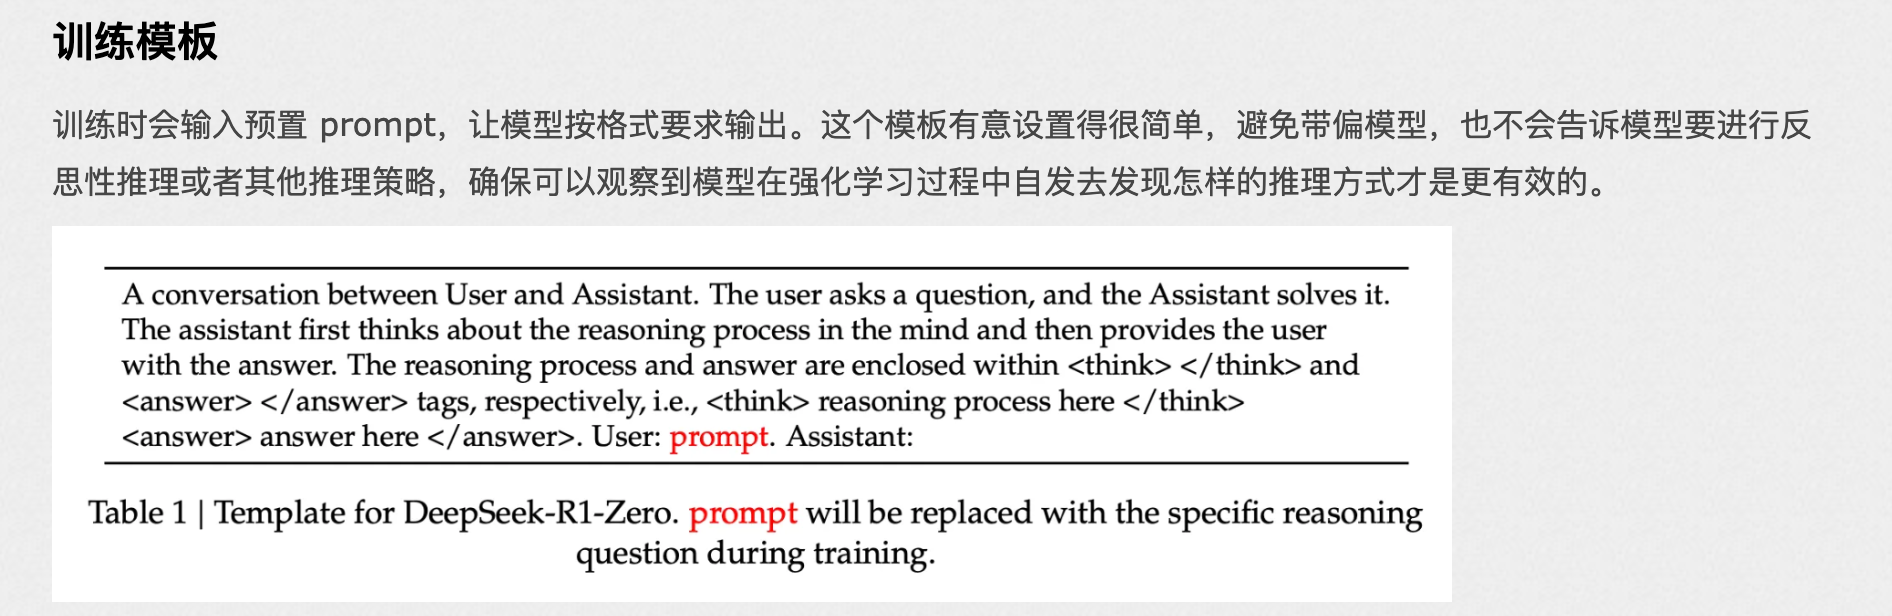
训练模板
R1-Zero的缺点
训练一个R1模型
R1训练的第二阶段
用R1蒸馏小模型
什么是“知识蒸馏”呢?软标签/硬标签/温度
蒸馏 vs 强化学习
吐槽一下:稳定性 and 黑话太多
----------------分割线------------
阅读材料
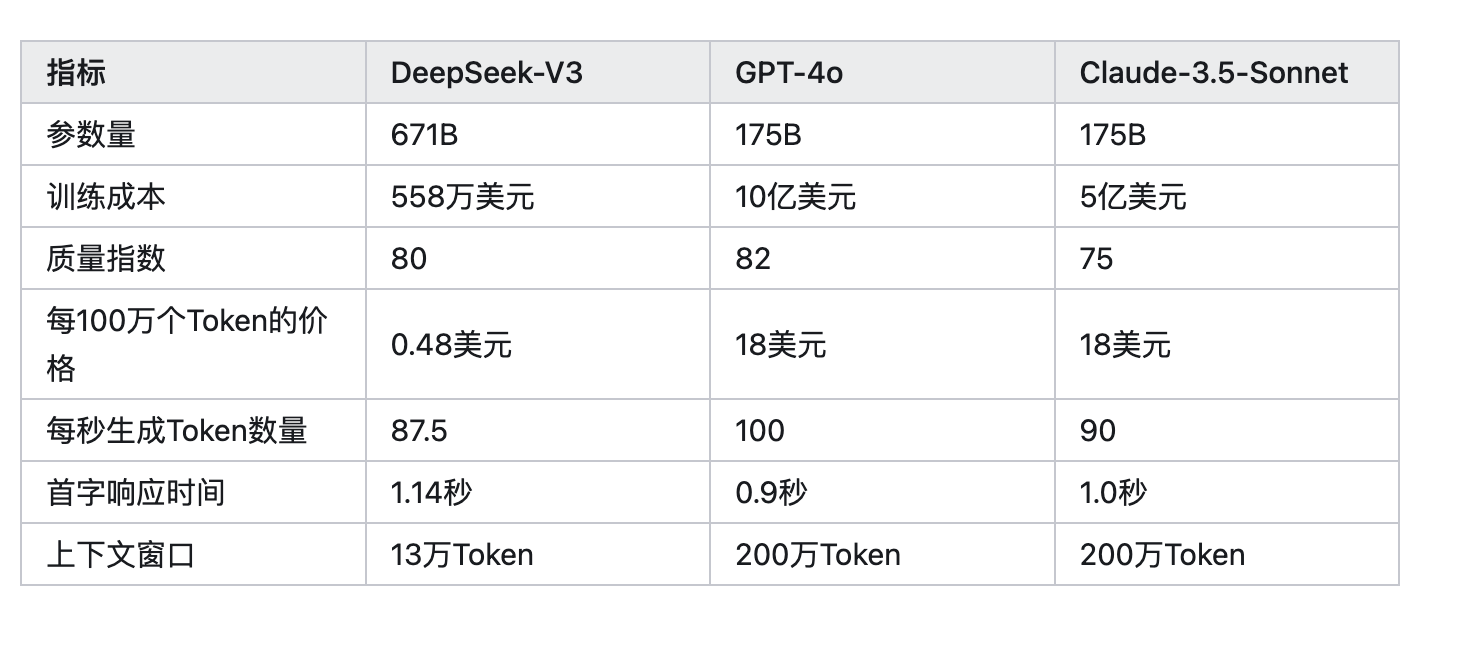
V3的训练成本比较
强化学习中的GRPO和PPO
R1-Zero的训练模版
R1的二阶段训练总过程
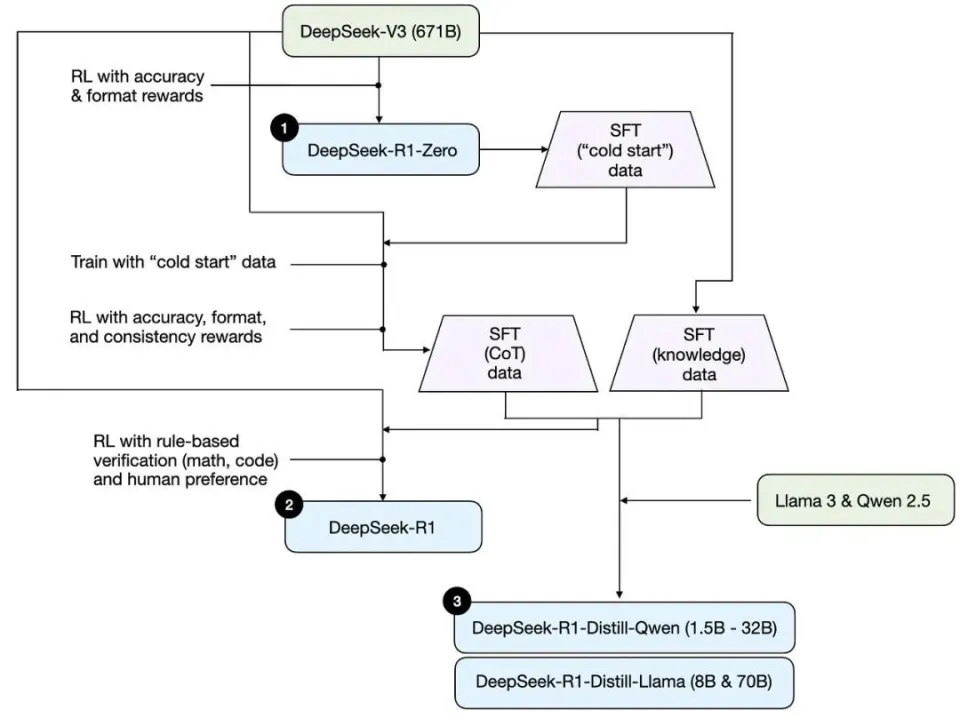
https://arxiv.org/abs/2501.12948
DeepSeek R1 是怎么训练出来的?- R1 论文精读
说明里标出的时间点,点一下跳过去
11 月 1 日 · 53 分钟
ep149 TOKEN2049 刷屏这周,聊聊币圈十几年的骗子们
10 月 11 日 · 55 分钟
9 月 13 日 · 55 分钟
9 月 5 日 · 1 小时 34 分
朝十晚久 · 2025 年 2 月 15 日 · 54 分钟
DeepSeek已经炸了,已经破圈了。本期节目,我们尝试挑战一下用大白话讲述一下DeepSeek模型背后的真实。DeepSeek V3 进化 DeepSeek R1-Zero 进化 DeepSeek R1 ! 幻方到底做了哪些技术创新和奇技淫巧,让DeepSeek突然爆发成为全球顶流?所谓的“多快好省”体现在具体什么地方?
如果你不想再人云亦云地复读DeepSeek模型花钱少,那么听一听本期节目包收获的。
主播:松阴
节目开始前,请大家加入听友群(加群方法见播客介绍页),以及帮忙多多转发!
当我们谈论DeepSeek,我们到底在谈论什么模型?
DeepSeek的训练成本500万美元?!
美国业界在V3刚出的时候就注意到了
MoE 混合专家模型
门控网络:混合专家模型里的“分检”
多头潜在注意力 MLA
FP8的大模型实现
DeepSeek到底有1万张A100显卡吗?
R1-Zero的Zero来自于Alpha-Zero
强化学习 vs 监督学习
GRPO(Group Robust Preference Optimization ) vs PPO(Proximal Policy Optimization)
训练模板
R1-Zero的缺点
训练一个R1模型
R1训练的第二阶段
用R1蒸馏小模型
什么是“知识蒸馏”呢?软标签/硬标签/温度
蒸馏 vs 强化学习
吐槽一下:稳定性 and 黑话太多
----------------分割线------------
阅读材料
V3的训练成本比较
强化学习中的GRPO和PPO
R1-Zero的训练模版
R1的二阶段训练总过程
https://arxiv.org/abs/2501.12948
DeepSeek R1 是怎么训练出来的?- R1 论文精读
说明里标出的时间点,点一下跳过去
https://feed.xyzfm.space/jwdf9qdymp4j复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →